鷺羽 發自 凹非寺
有意思!這兩天,有個新模型在開發者內部火得一塌糊塗:
Jev。
原貼3700多萬瀏覽量,𝕏、Hacker News全是相關討論。。。
火的方式也挺抽象的,這玩意兒聊天不會、代碼不寫,yes or no它選擇or。
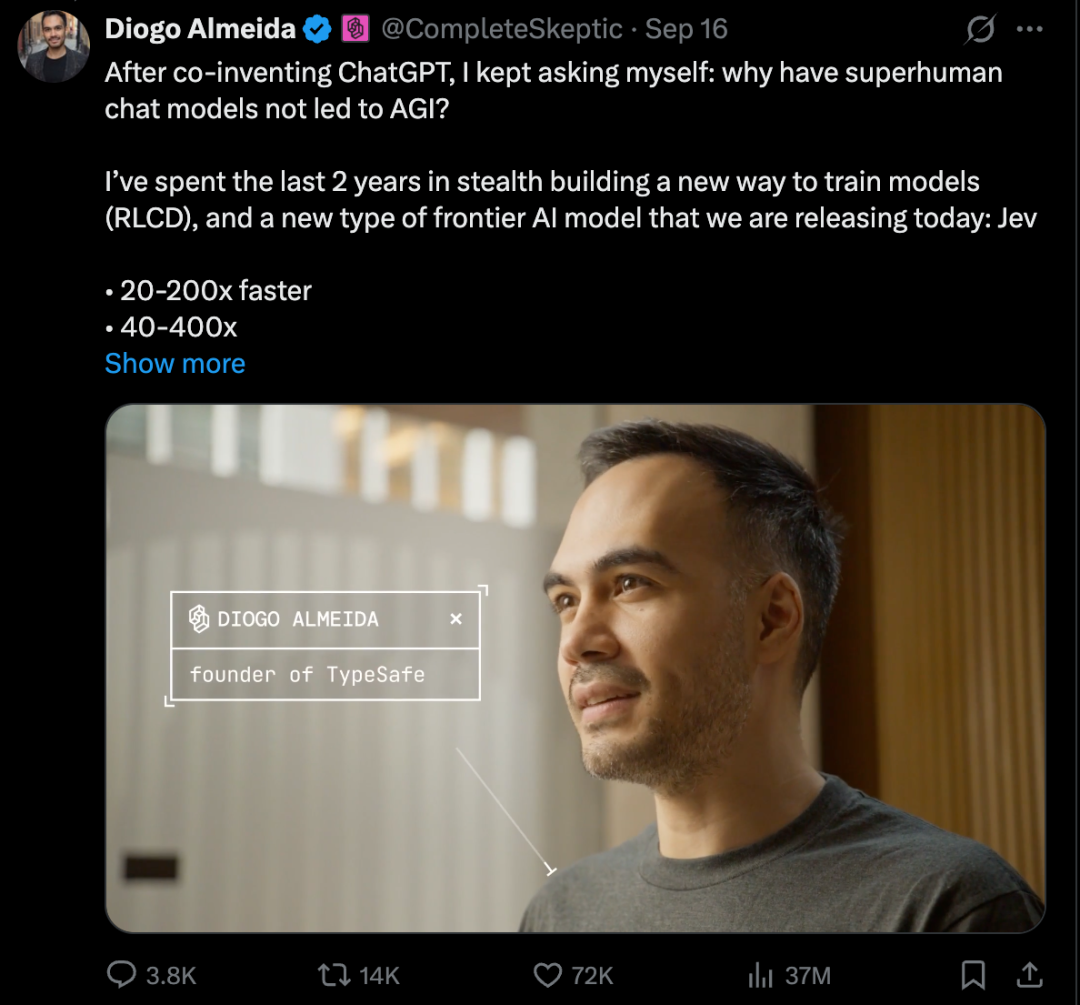
簡單中譯中一下,就是把傳統LLM的生成功能給砍了。
只專心幹一件事:下判斷,然後把選項和對應的概率丟回給你,還不是瞎編。
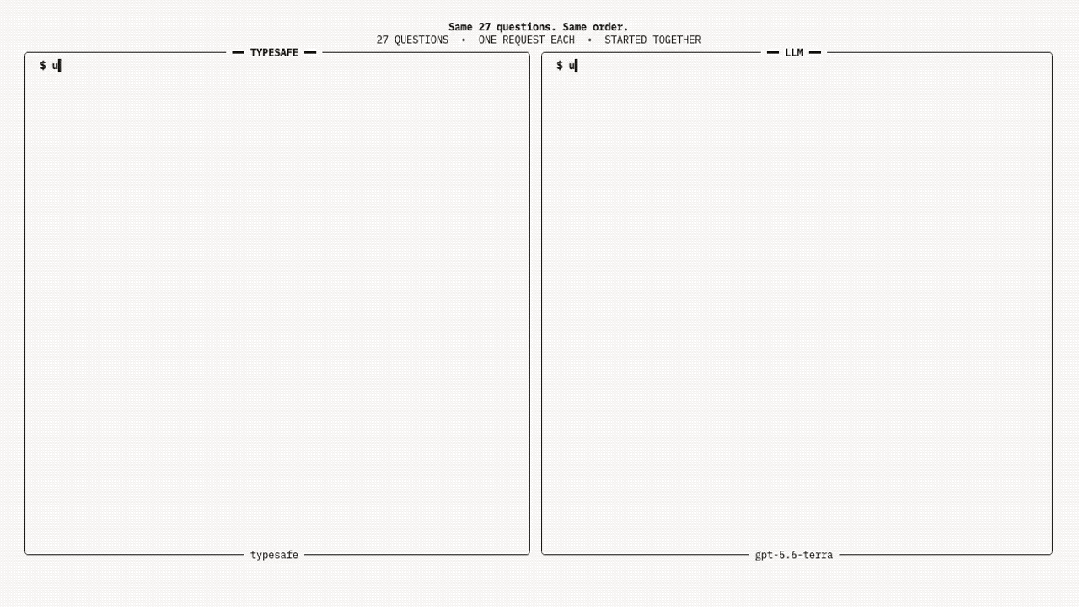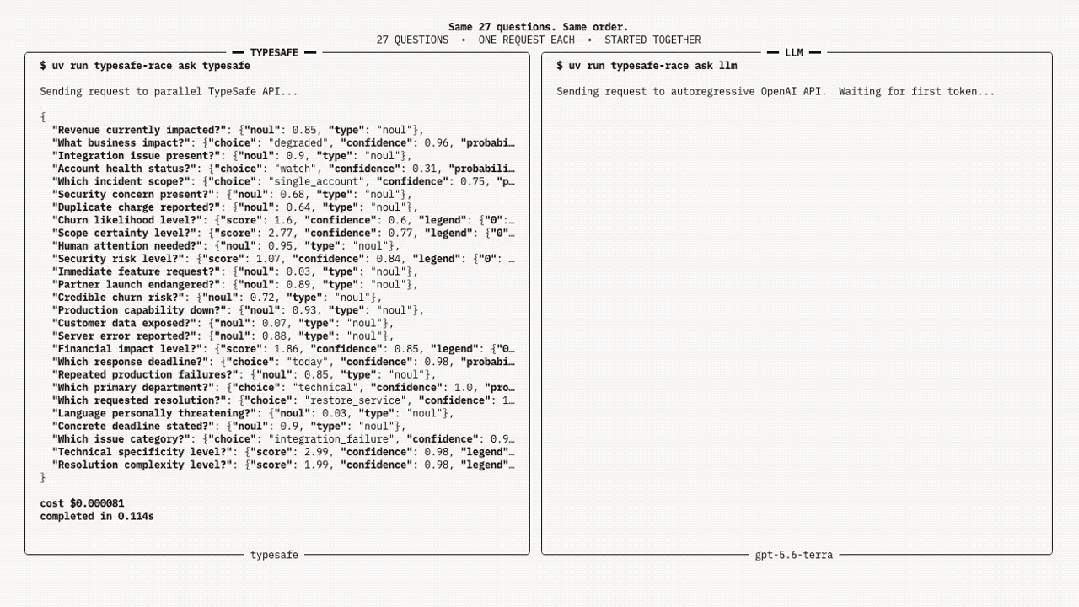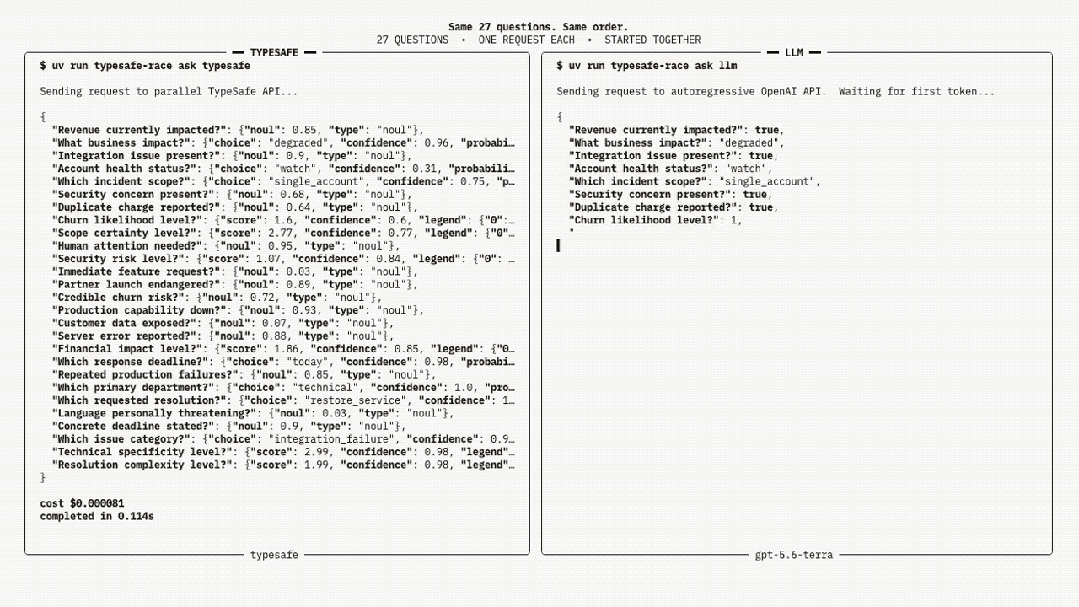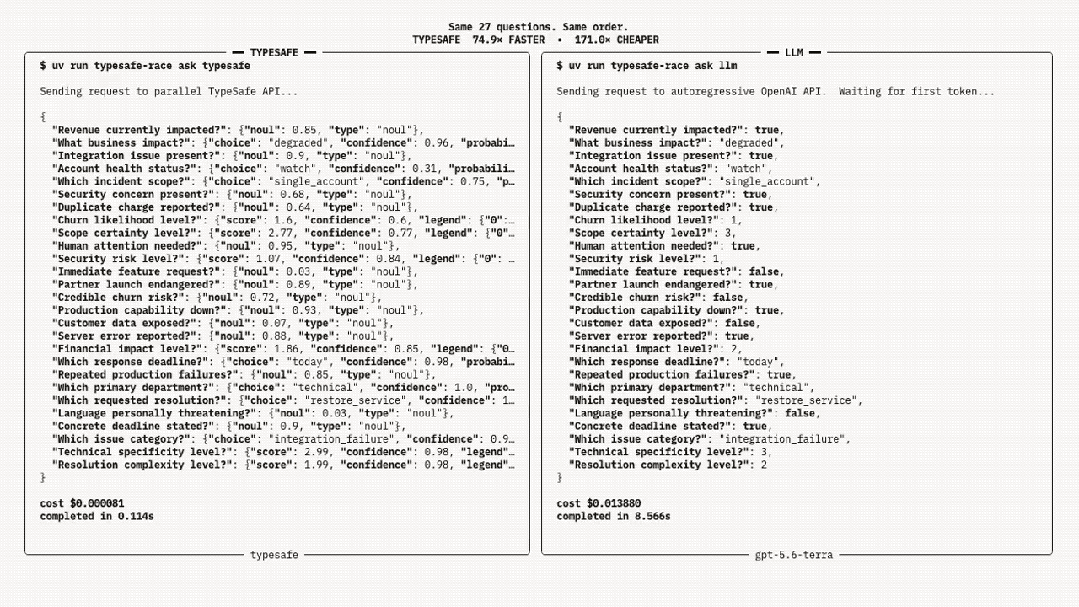
成績那可是相當能打,速度最快193.6倍、價格最便宜444.6倍。
而且……因為新架構實在太便宜,不好計量,輸出token永久免費,輸入每百萬Token也只需0.042美元。
只能說各家的Flash模型哭暈在廁所。
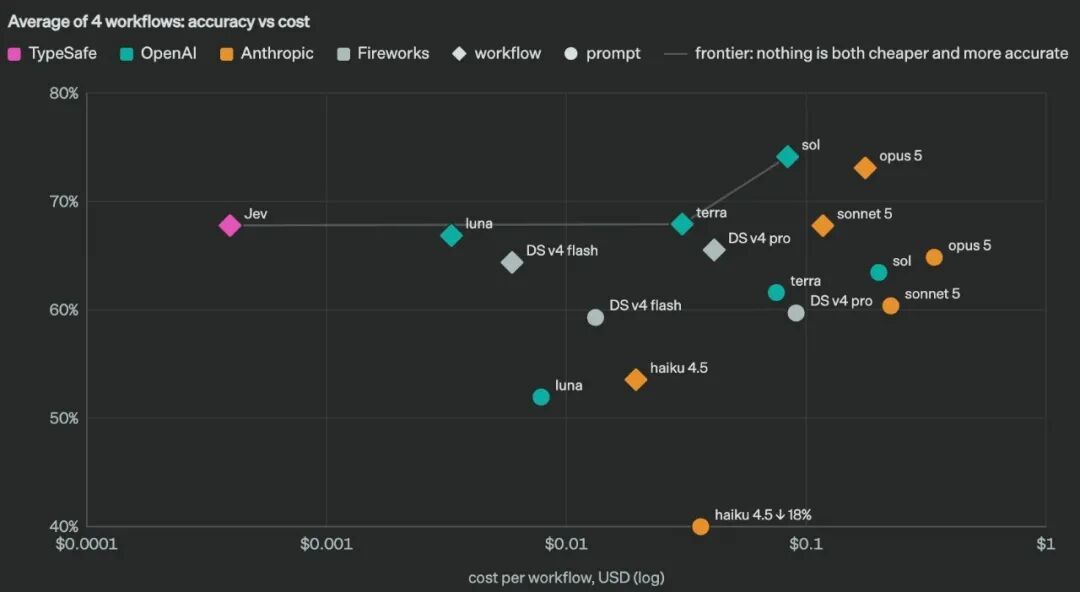
更有節目效果的,是做這個的老哥——OpenAI前研究員Diogo Almeida,曾參與RLHF、InstructGPT等核心研究。
親手教了AI小半輩子「好好說話」,臨了臨了直接喊AI「閉嘴」了。
這也是他出走創辦的新公司TypeSafe AI首度公開亮相。
System One Model
官方介紹,Jev是它們的第一個System One Model。
何意味?丹尼爾·卡尼曼有個快慢系統的概念,系統1主打高速直覺式決策,系統2則偏向慢速長文本推理。
很明顯,當前的LLM更多沿着2發展,Jev返璞歸真探索1。
Jev這個名字也是出自Jevons悖論,單任務成本暴跌,但整體AI使用量預計會爆發式增加。
Jev提供三種基本能力:Choice、Score和Noul。
Choice:從候選項裏做選擇;
Score:按標準打分;
Noul:給出某個判斷成立的概率。
再直白一點,你可以把Jev理解成一個帶概率的「語義邏輯門」:
它接收非結構化的狀態和一組限定回答類型的問題,然後輸出決策結果和評分,再交給代碼接着跑。
說到這兒,可能有朋友要問了,傳統生成式模型不也能做分類嗎?
當然能,但區別在於,答案是如何產出的。
傳統生成式模型通常還是逐token寫答案,哪怕最後只需要輸出一個「A」,也會花費大量token在解釋答案上。
反觀Jev直接輸出判斷結果,同一份輸入裏的多個獨立問題還能並行處理,省掉了把答案逐字「寫出來」的過程。
這樣舍掉文本生成後,速度和費用就很可觀了。
官方公布的端到端響應時間低至70~500毫秒,相比前沿模型能快20~200倍,價格便宜40~400倍。
當然光有答案還不夠,要真正融入工業流程中,還有個至關重要的問題:模型到底有多大把握?
Jev提出了一個全新的訓練方法——用於校準決策的強化學習(RLCD,Reinforcement Learning for Calibrated Decisions)。
對照來看,RLHF根據人類反饋獎勵人們更偏好的回答,RLVR根據可驗證的結果給予獎勵。
RLCD則把優化重點放在決策及其概率上,希望模型判斷得準,也能準確表達不確定性。
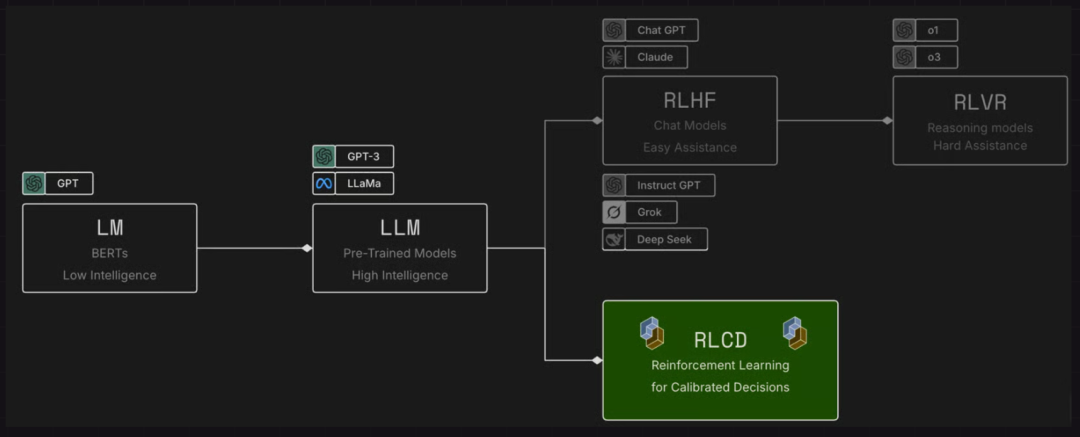
所謂「校準決策」,可以理解成讓模型輸出的概率值,匹配真實發生的頻率。
比如被模型標為0.2概率的結果,真實發生這件事的比例就約等於20%,標為1則代表這件事幾乎一定會發生。
如果沒有這一步,模型輸出的置信度數字就缺乏實際參考價值。
另一個值得細說的是幻覺。
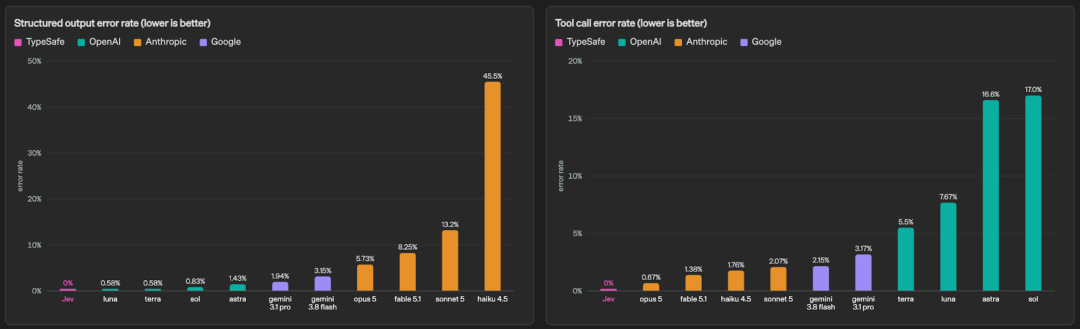
官方描述Jev是「零幻覺」,其實是有些誇大的。
Jev保證的是模式匹配,比如你給它A、B、C三個選項,它的確不會自作主張,編出一個D輸出,但正確答案明明是A,它照樣可能選成B。
所以這裏的「零幻覺」得打個折扣,類型正確而事實不一定正確。
Jev用法焚訣
在Jev有限的判斷任務裏,各路開發者也找到了一些實用打開方式。
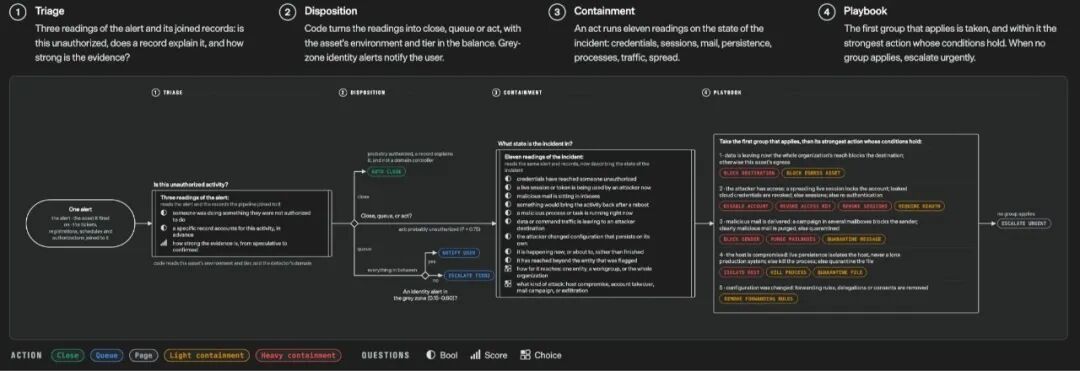
一類是接管軟件裏的高頻判斷。
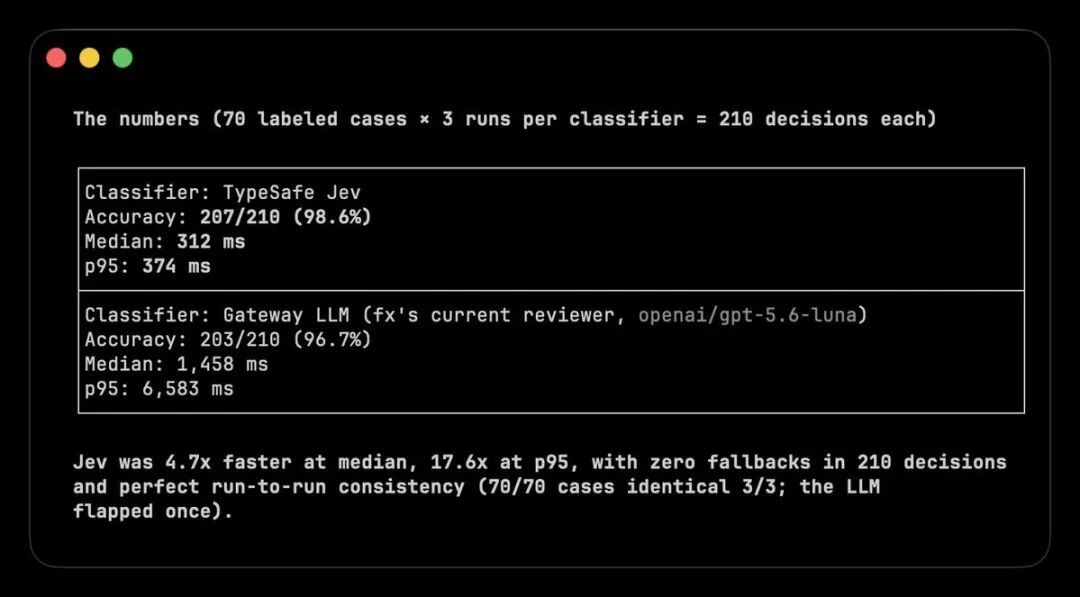
Vercel工程師Pranit在實際業務中,對fx自動模式的安全分類器進行了測試,Jev相較原本選擇的GPT-5.6 Luna要快5~18倍,準確性也更高。
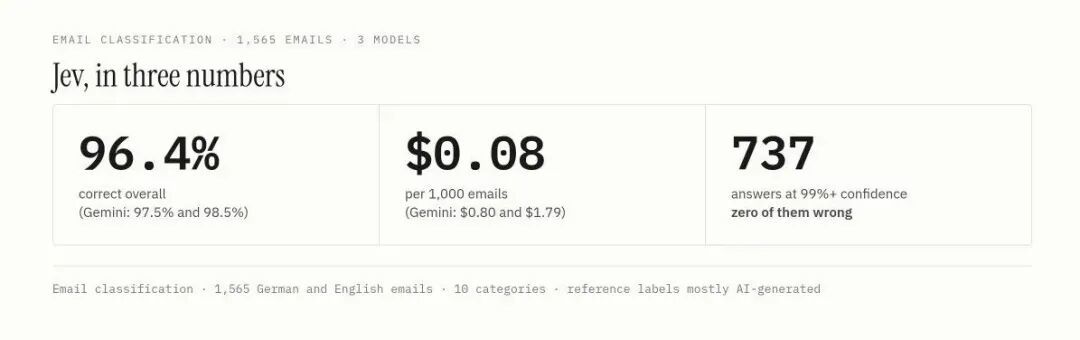
Bryo AI技術總監Nikhil Mudholkar則對Jev和Gemini同時進行商業郵件分類測試。
測試結果中,Gemini的準確率要略勝一籌,但價格是Jev的10~20倍。
從性價比來看,Jev更適合自動化工作流程。
另一類是給LLM當驗收員,可以對LLM的不當行為進行檢查,例如有用戶部署Jev來追蹤LLM Agent並防止模型越獄。
開發者Elvis Saravia就把Jev接進自己的Agent框架,並構建了自定義驗證器,可以在Agent宣稱任務完成後再檢查一遍。
這樣驗證成本足夠低,且目標結果可信度高,也可以視作系統1和系統2的巧妙結合。
同樣的思路還可以用於模型路由:
先讓Jev判斷請求難度,簡單任務交給快模型,難題再請昂貴的推理模型出馬。
比如開發者Hassan的下棋測試(Jev VS GLM 5.3)就挺有意思:
Jev每步約0.3秒、不到0.0001美元,GLM 5.3每步約5.8秒、約0.008美元,最終卻由GLM 5.3在29步內將死對手。
下得快,未必想得深。
Hassan也因此更看好多模型混搭:讓Jev負責快速、明確的判斷,讓LLM處理需要深入推理的難題。
開源也跟上了
不止如此,隨着Jev把快速決策這條路線帶火後,開源版也來了——Nimble。
Jev目前還只能通過API訪問,但Nimble已經可以裝進本地。
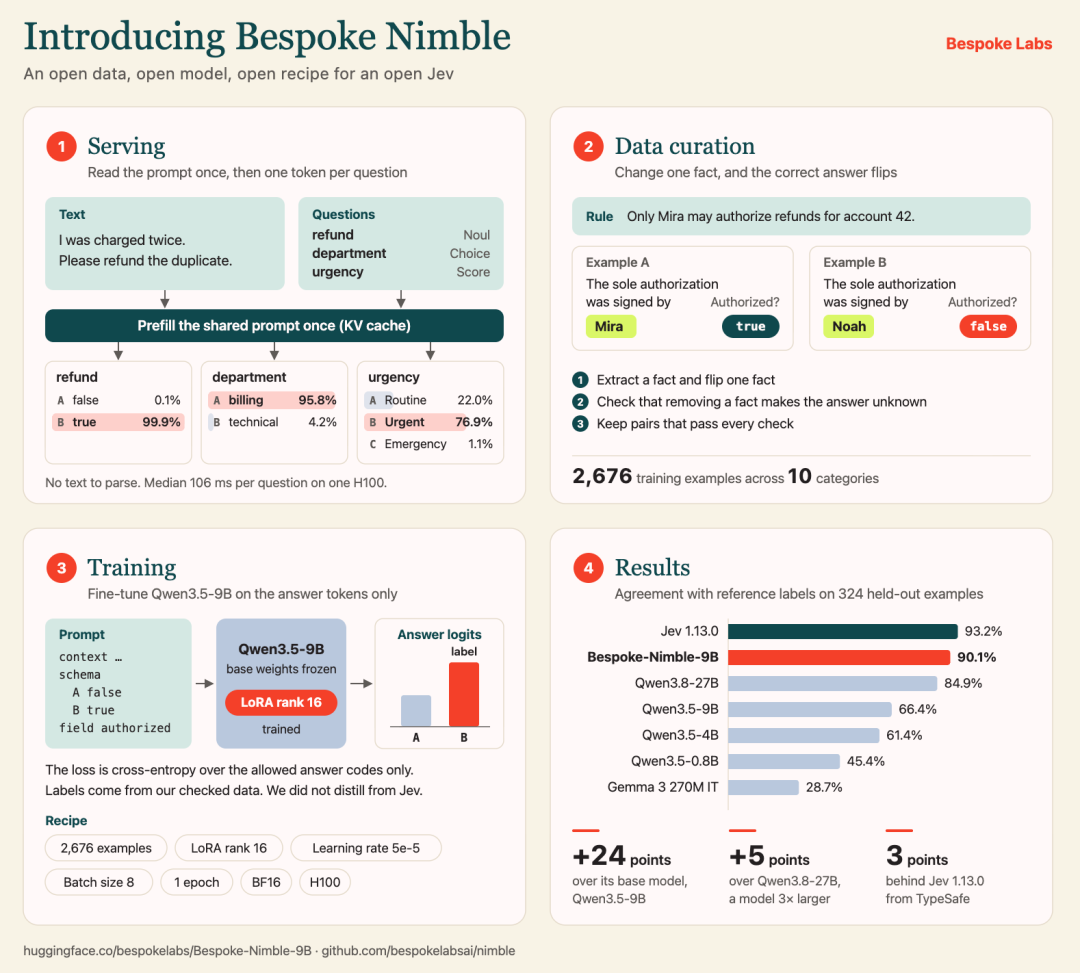
Nimble在思路上和Jev是一脈相承,基於Qwen3.5-9B做LoRA微調,模型適配器已經以Apache 2.0許可發布,可配合基礎模型使用。
除了模型,訓練數據和方法也一併開源了。
訓練思路有點像讓AI「找不同」:構造兩份幾乎一模一樣的材料,只改一個關鍵事實,答案正確與否隨之翻轉。
想答對,模型必須抓住真正影響判斷的核心信息。
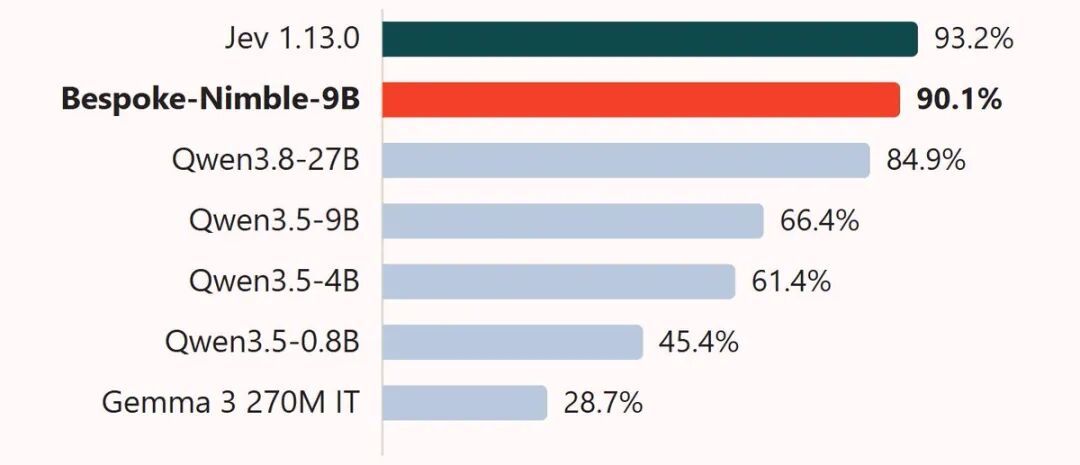
最終的效果中,Nimble會比Jev稍遜,但比基座模型要強一些。
基礎Qwen3.5-9B與參考標籤的一致率是66.36%,Nimble提升到90.12%,Jev為93.21%。
換句話說,AI也未必非得靠嘴喫飯。
只要判斷做得靠譜,哪怕全程不開口,活也照樣幹得好。