就在今天,整個硅谷都被Jev 刷屏了!
發布僅三天,它就被Vercel、Cloudflare和LangChain等主流平台迅速集成,有人說,我們即將迎來自動化智能的大爆發!
而這場狂歡的主角,竟然是一個不會說話的大模型。
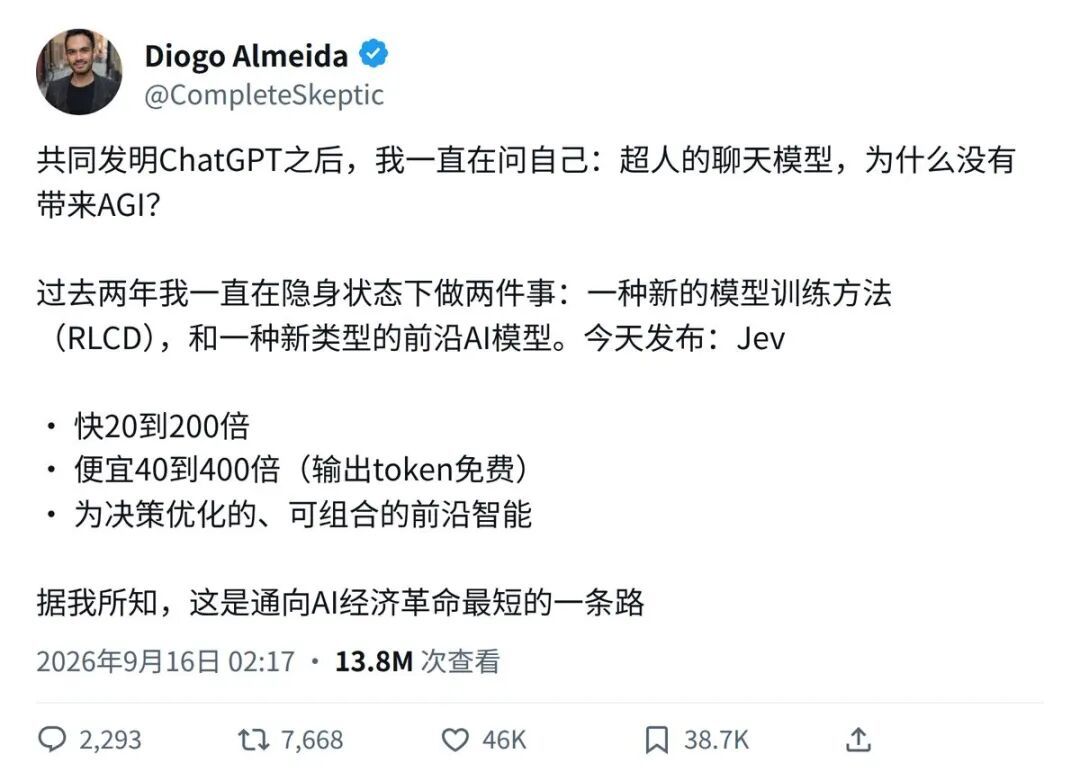
9月16日,ChatGPT核心發明人之一、InstructGPT論文第四作者Diogo Almeida連發長推,直接向行業開炮,當年那條路,咱們走偏了!
他端出的解法,便是Jev。
它不寫文章也不陪聊,你扔一堆亂七八糟的數據進去,它只用70毫秒就甩回一個帶概率的判斷,輸出token永久免費。
然後,整個事態就徹底失控了。
不到36小時,就有多達14萬名開發者如餓狼般湧入內測。
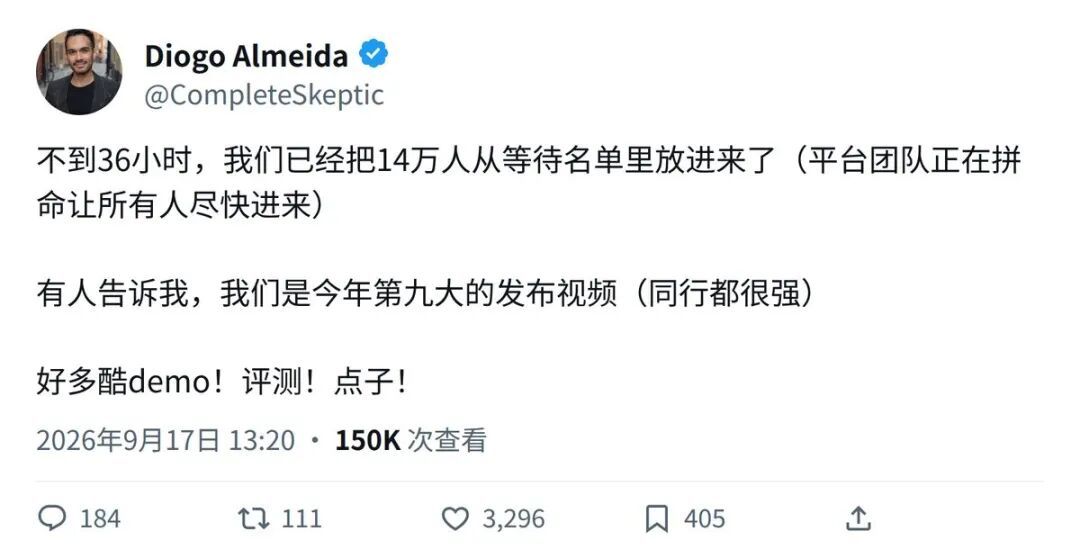
現在,Jev的用例已經冒出來幾百個。
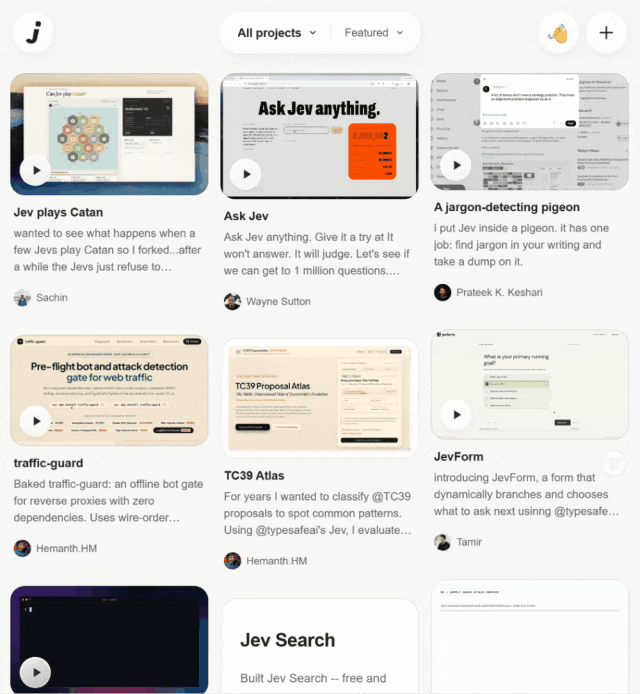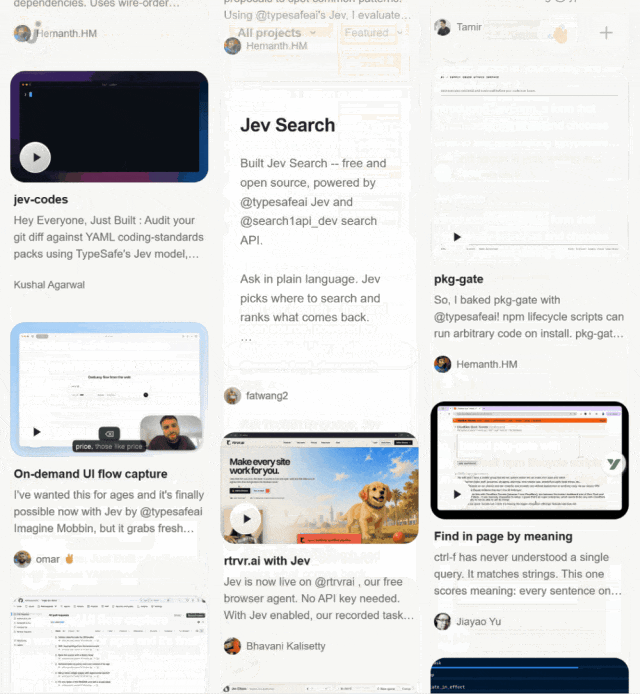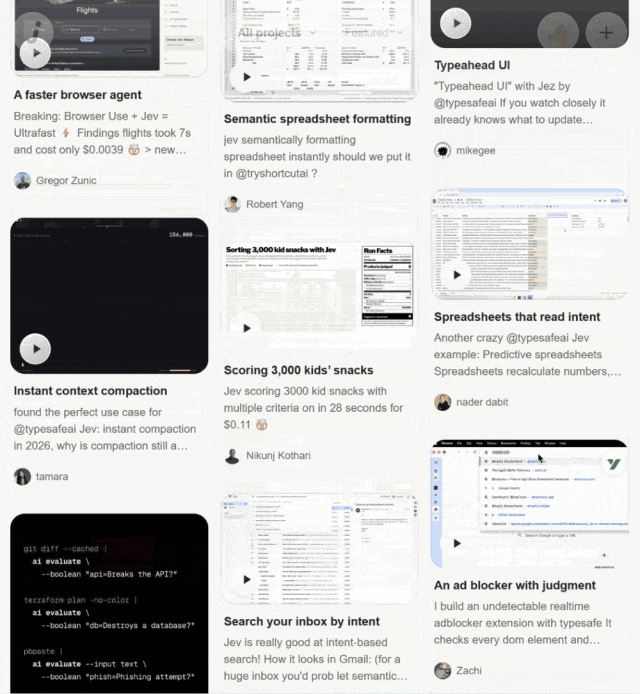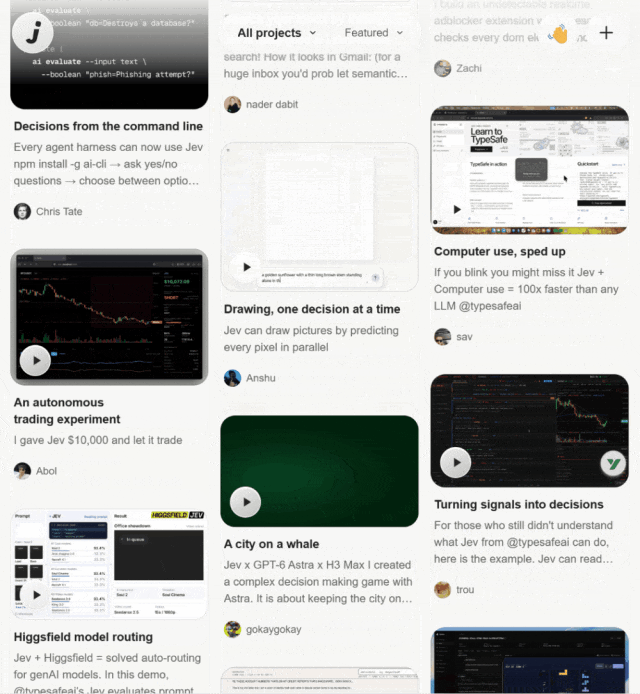
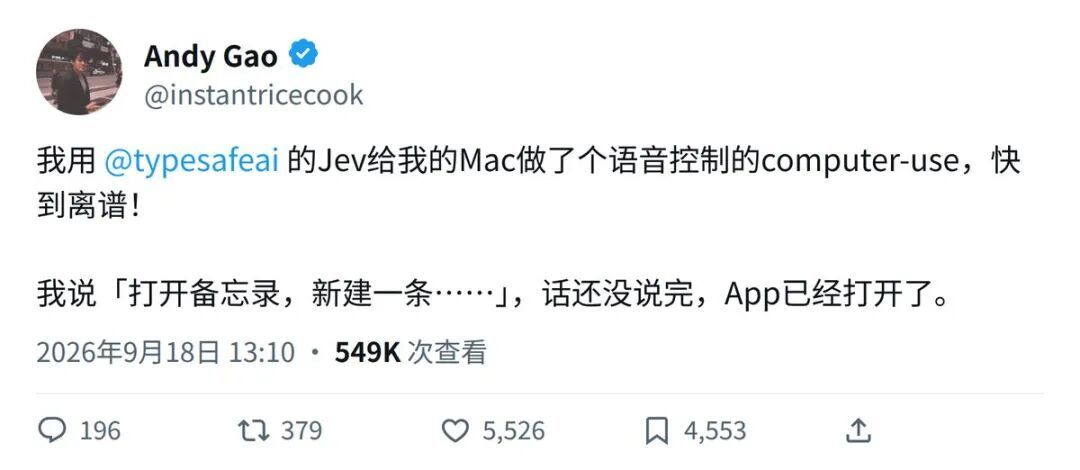
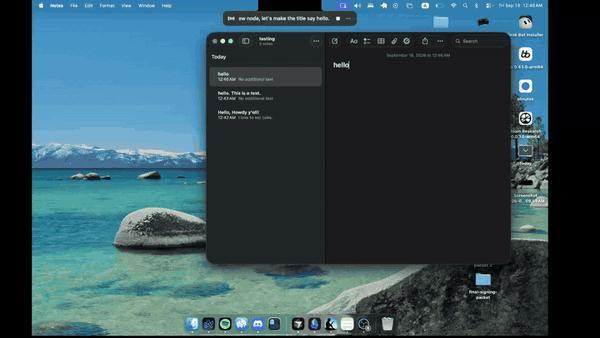
有人給Mac糊了個語音助手,打開備忘錄,新建一條……話還沒落音,App已經秒開。
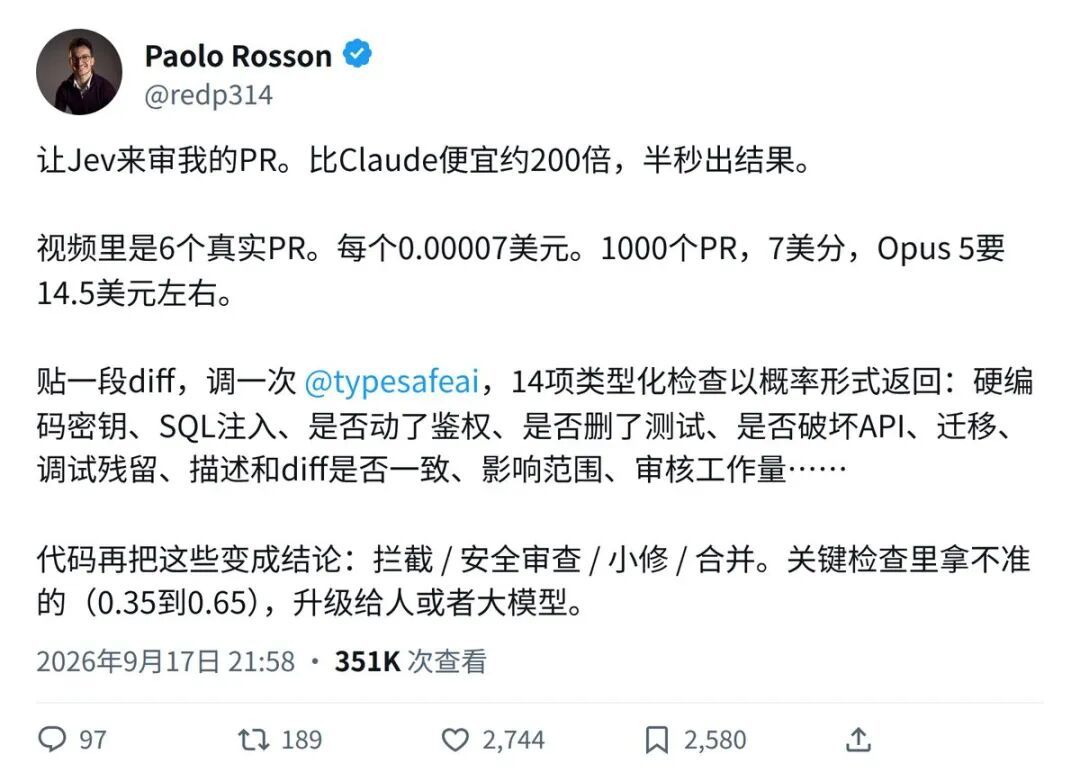
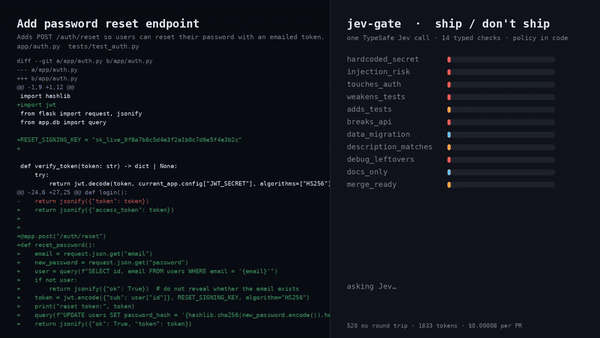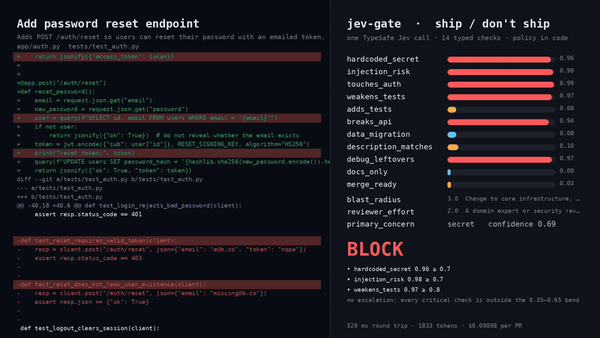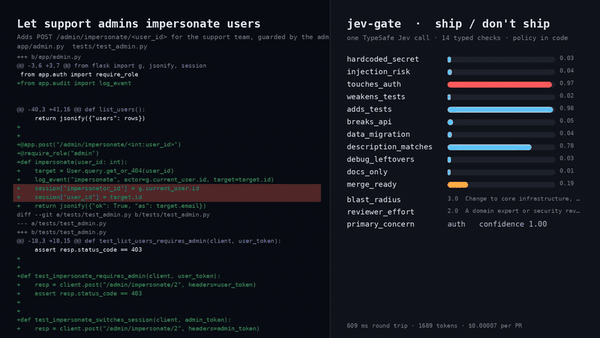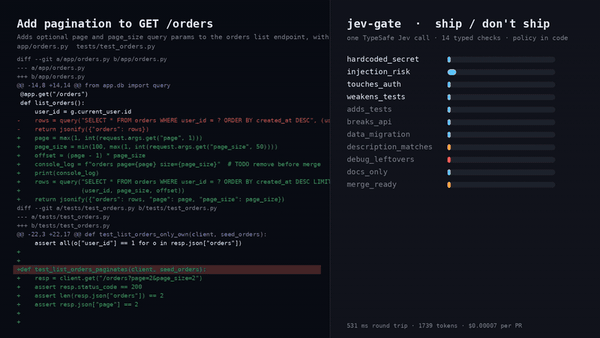
還有人拿它審PR,一次7萬分之一美元,1000個PR才花7美分,同樣的活交給Opus 5得燒掉14.5美元。
就連老大哥谷歌都坐不住了。
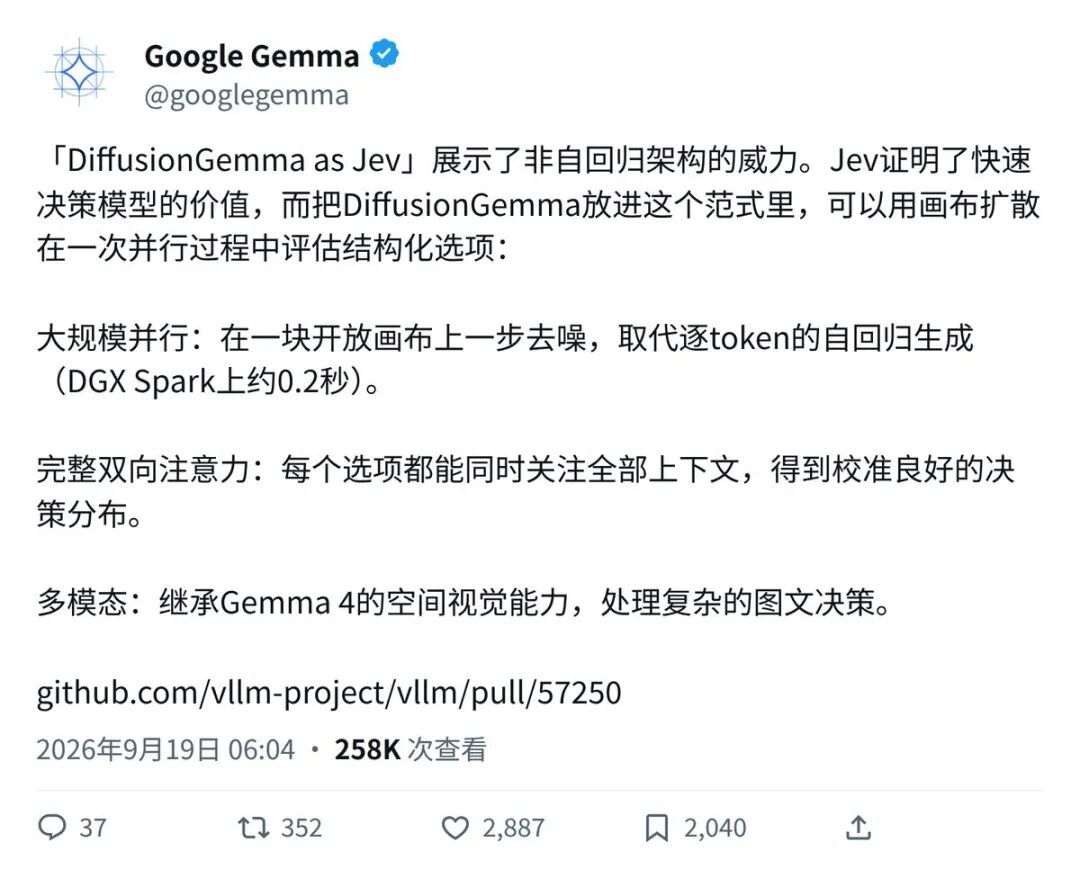
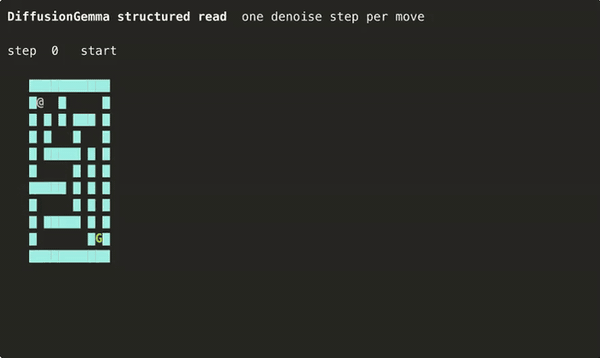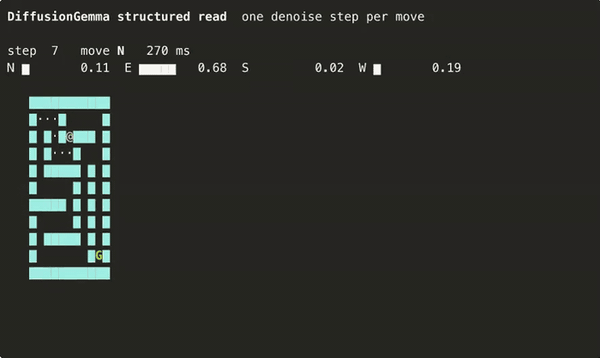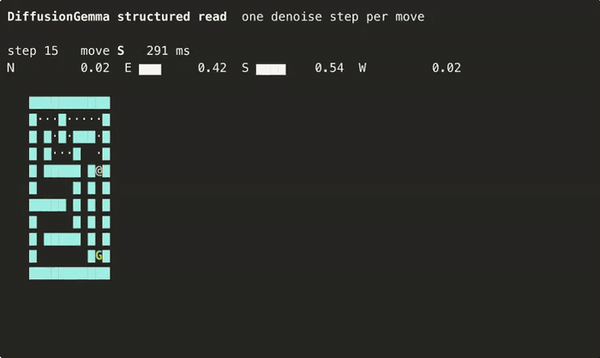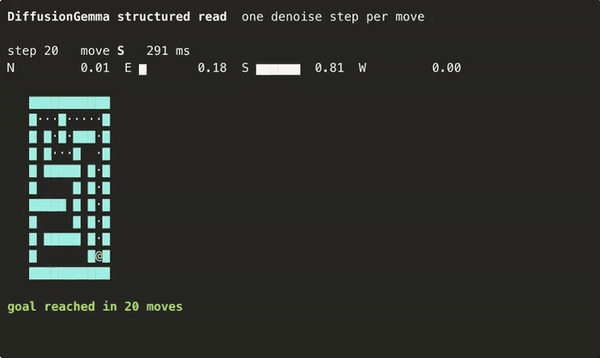
Gemma官方賬號火速發了條DiffusionGemma as Jev,直接把自家的擴散模型塞進這個新範式,一步去噪、一次性並行給出所有選項的概率,甚至還順手把視覺能力也給補上了。
狂歡之下,壓着的是一個最致命的老問題,智能到底是什麼?
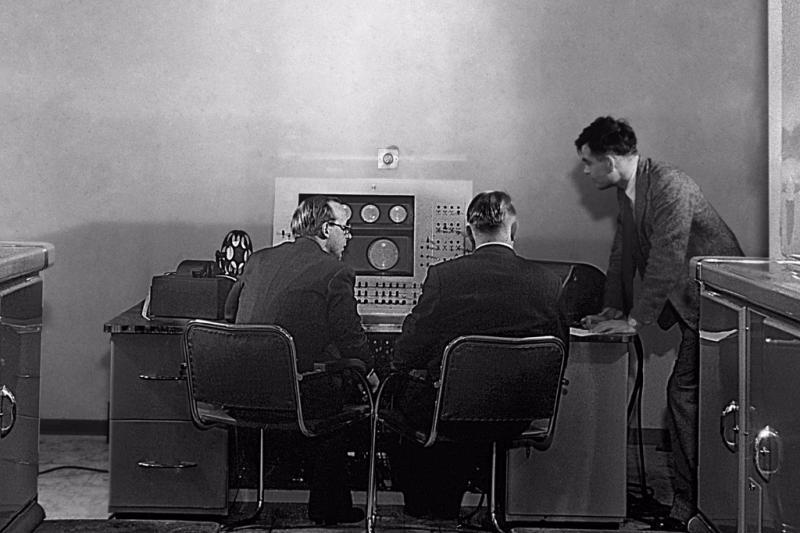
七十多年前圖靈定下考題,機器能不能思考,看它能不能在對話裏騙過人。整個行業從此朝着把話說漂亮狂奔,而ChatGPT幾乎把這條路走到了極限。
或許,這是AI史上最大的一次勝利,但也是最大的一次跑偏。
我們花了七十年、燒了千億美元,終於教會機器把話說得比人漂亮,然後發現自己造出來的東西,依然什麼都不敢讓它自己決定。
背後的原因在於,我們荒謬地把嘴當成了腦子。
地球上的智能演化了幾億年,絕大多數生死攸關的決策,在被說出來之前就已經做完了。至於語言,不過是最後幾十萬年才長出來的一層薄皮。
在Almeida眼裏,ChatGPT和Claude Code沒有任何代差,同屬一箇舊時代。
而Jev,就是他砸向新時代的第一份答卷,把嘴縫上,只留判斷。
聊天超人三年了
說好的真自動化在哪?
故事的主角,名叫Diogo Almeida。
他是OpenAI早期最核心的研發人員之一,是RLHF和InstructGPT的核心奠基人。
但在ChatGPT爆火之後,Diogo卻陷入了深深的懷疑。
他寫道:
在共同發明了ChatGPT之後,我一直在問自己:為什麼超人類的聊天模型沒有帶來AGI?
這麼聰明的AI,到今天還得靠人類盯着才能幹活。根本做不到真正的自動化,也就是讓軟件中無人值守時自己決策。
他發現了一個致命問題:RLHF讓模型學會了取悅人類,卻也讓它們在系統自動化場景裏變得極其不可靠。
當年讓ChatGPT一夜封神的RLHF,教給模型的是怎麼回答能討好人類。
而這套機制從第一天起,就是為輔助而生的。模型乾的每件事,最後都得有個人看一眼。
你現在指望它去跑無人值守的硬核業務?對不起,它從一開始就沒受過這種訓練。
更致命的,是他這兩年纔想明白的一件事:你優化什麼,就會得到什麼。而字符串,恰恰是世界上最難優化的東西。
為了讓長文本不跑偏,訓練時就得把模型調得過度自信,逼它主動丟掉那些低概率的選項,把輸出按在主幹道上。
這樣做的代價就是,當大模型信誓旦旦跟你說這事我有八成把握時,這八成全是水分,你根本不敢信。
換句話說,在文字輸出上追求絕對的可靠性,是在逆着生成式AI的底層原理幹活。
Diogo意識到,讓AI擁有好口才,反而成了AI融入萬物代碼的最大絆腳石。
既然文字這麼難管,那乾脆就別讓它說話了。
於是,他果斷從OpenAI辭職,創辦了TypeSafe AI,從底層訓練架構開始推倒重來。
現在,他帶着他的答案——Jev模型,殺回來了。
System One:一個啞巴AI的降維打擊
Diogo Almeida給Jev起了個新名字,叫System One模型。
出處是諾獎得主卡尼曼的《思考,快與慢》。系統一,就是那種不用過腦子、憑直覺瞬間給出的本能判斷。
Jev用法非常簡單。
你輸入一段極其混亂的狀態(比如一封炸毛的客訴郵件,或者程序卡殼時的代碼),它會輸出一個類型化的決策,並附帶精確概率。
在此期間,它不會生成任何一個字。
官方文檔也只給了三種交互姿勢:
1. Choice,從給定選項裏挑一個;
2. Score,給個具體分數;
3. Noul,甩出一個0到1之間的概率值。
每個答案都帶着所有選項的概率分佈,外加一個整體置信度。
直接的結果就是,零幻覺。
因為模型的工作只是給劃定好的幾個選項分配概率。選項之外的東西,它想編也編不出來,程序拿到手的永遠是一個合法的值。
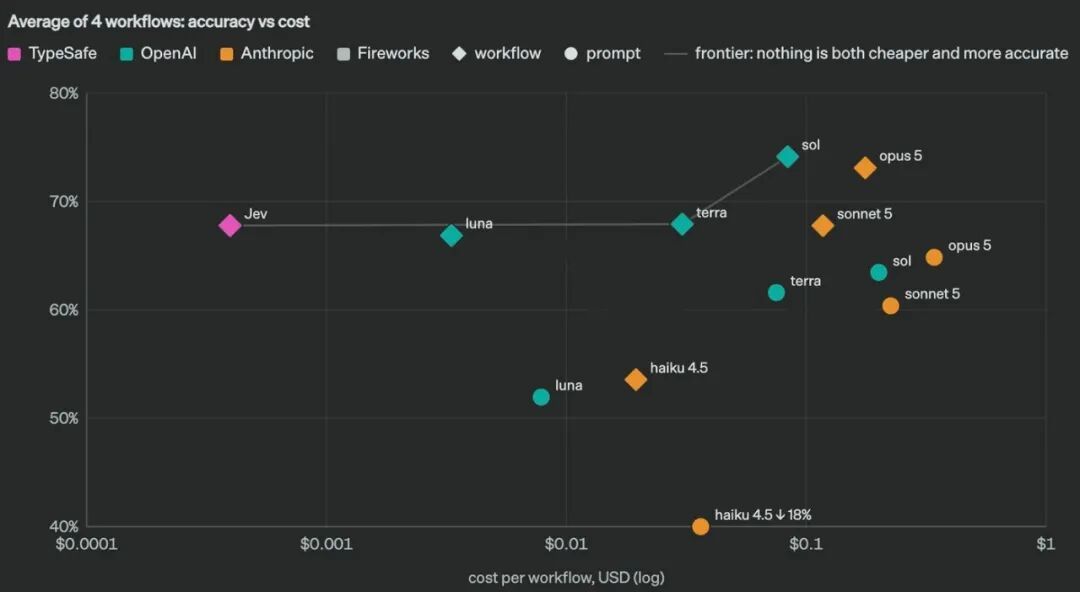
至於快,也是同樣的邏輯。
大模型是一個token一個token往外擠,Jev把所有輸出並行採樣,一次性全給完。
做一次判斷,Jev端到端只要70到500毫秒,同樣的活交給前沿大模型,要3到329秒。
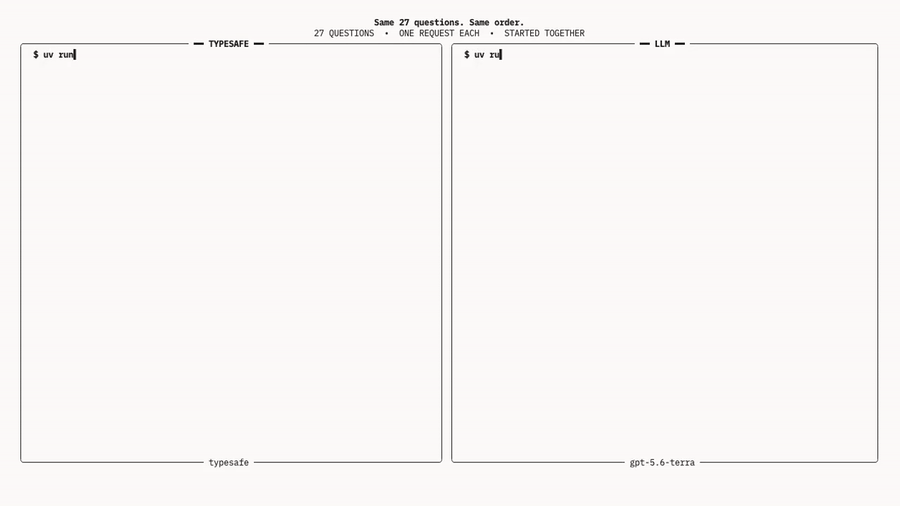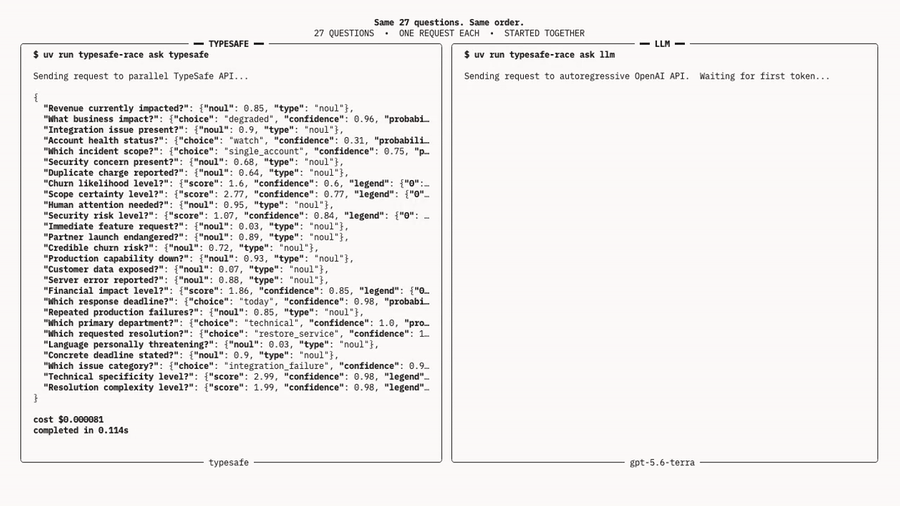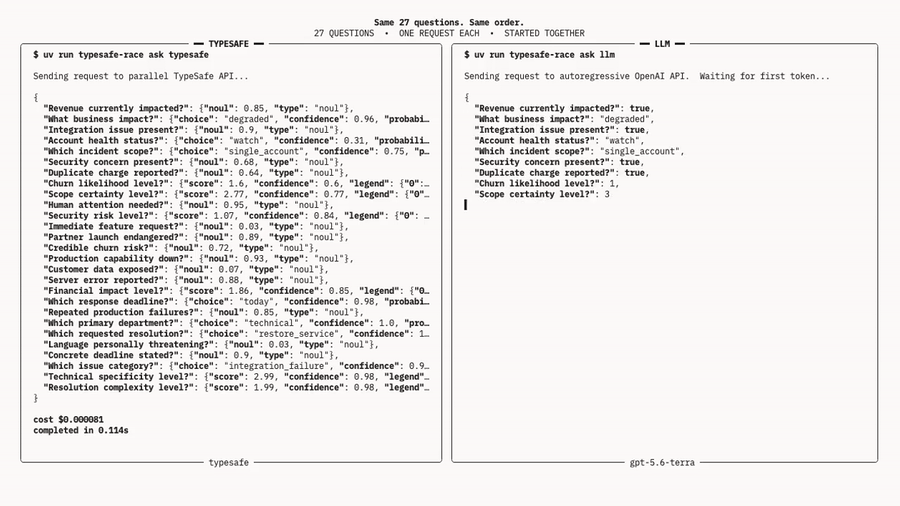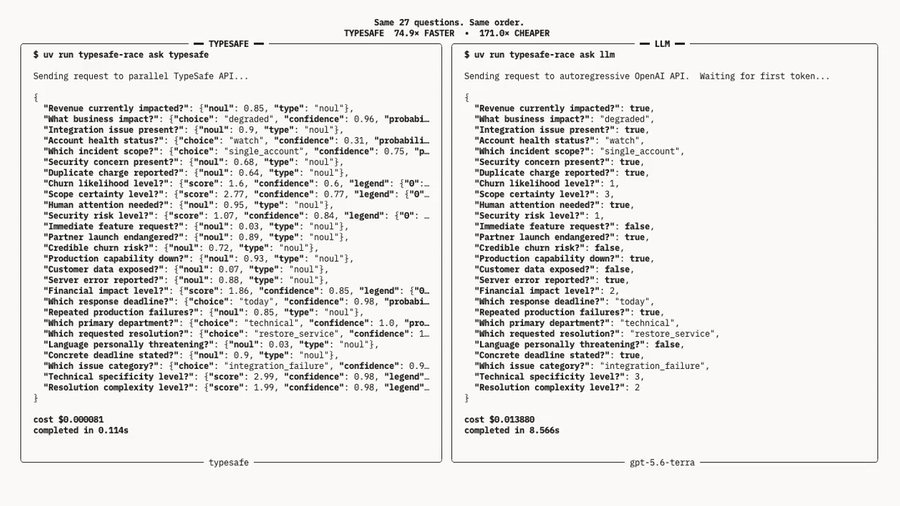
輸出token免費的底氣也源於此。
既然沒有逐字生成的過程,那就沒有值得計費的輸出。對此,博客原話非常囂張:便宜到根本不值得計費。
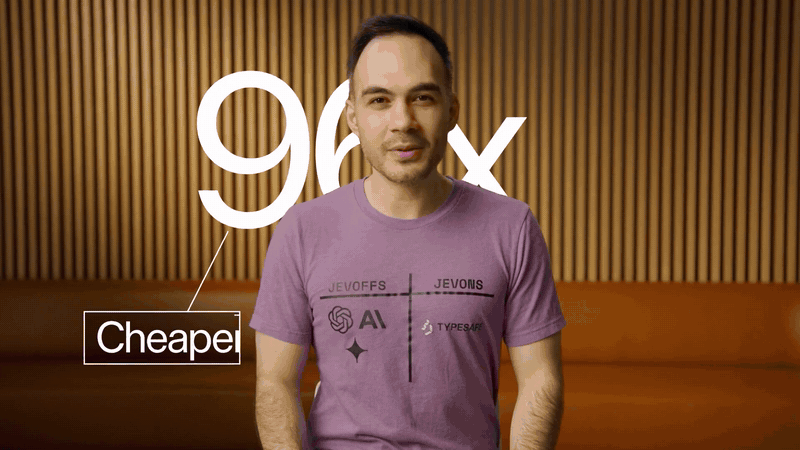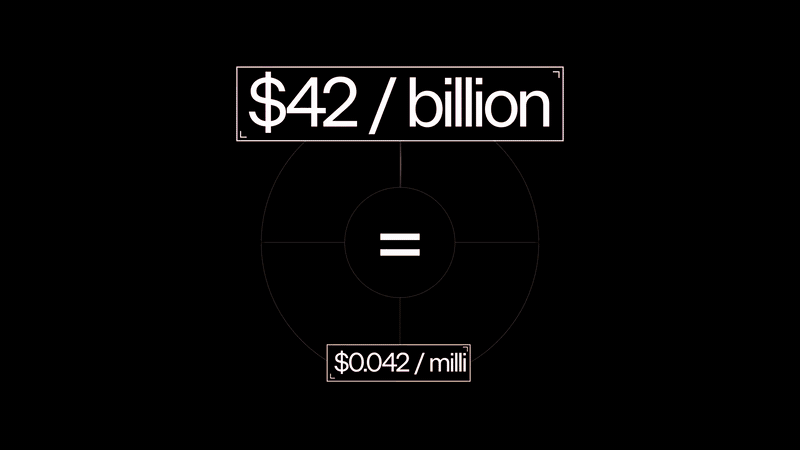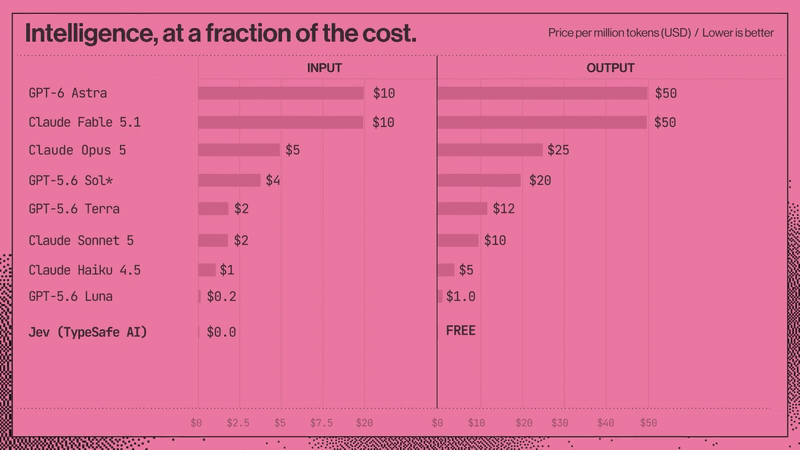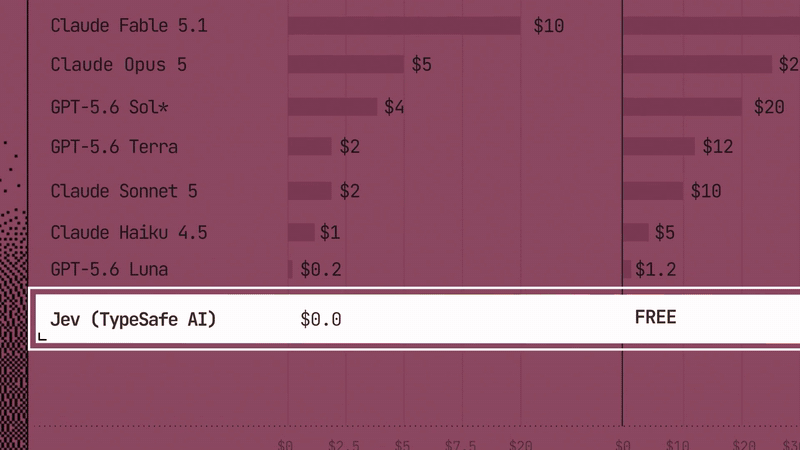
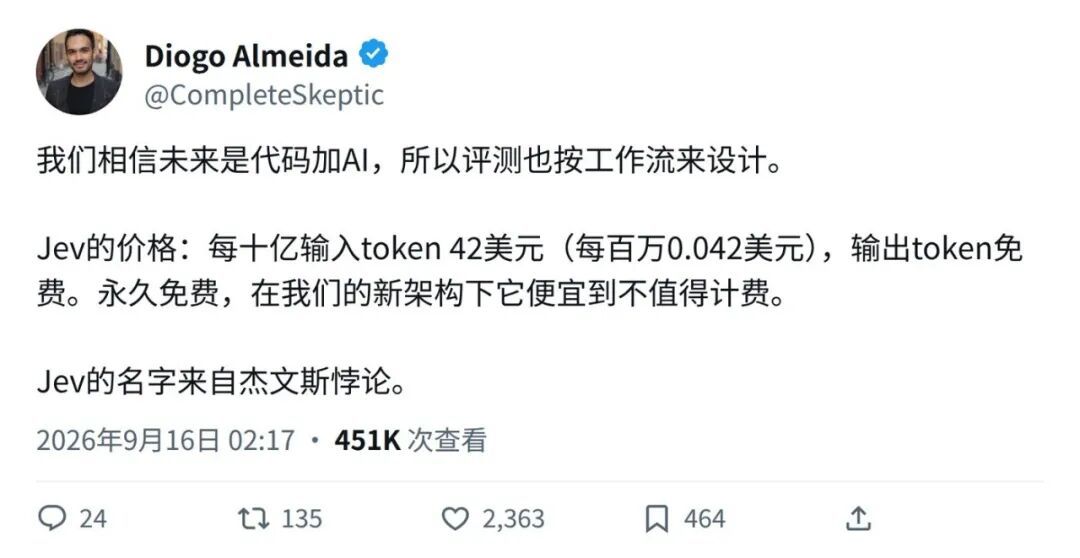
TypeSafe只對輸入收費,每百萬token僅收0.042美元。對比一下,Astra和Fable 5.1的輸出定價是每百萬token 50美元。
支撐這一切的,是一種叫RLCD(校準決策強化學習)的新訓練法。
RLHF獎勵的是人類看了很爽;RLCD獎勵的則是你給的概率,得和你的實際命中率咬合。模型說0.9,那就必須有九成的時候是正確的。
官方沒細說技術原理,但給出了一條結論:置信度越高,準確率越高。
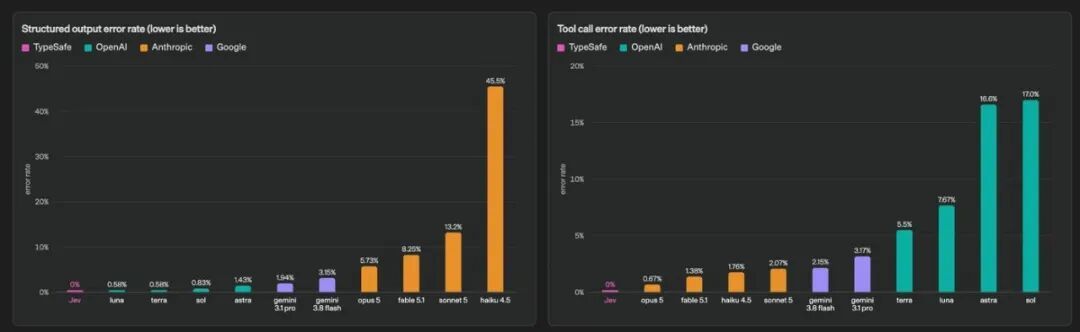
在用法上,Jev把可組合性玩到了極致。一個複雜的決策,可以直接拆碎了並行去問。
比如審一份商業計劃書,把市場規模、技術可行性、差異化全拆開,分別拿一個精準概率,軟件最後再做拼圖。
Almeida的原話是,零樣本+通用=可編程。任何一個判斷都能用幾行代碼描述清楚,根本不需要微調。
這和他當年做InstructGPT時下的賭注一模一樣,只要底座足夠通用,顛覆性的用例會自己長出來。
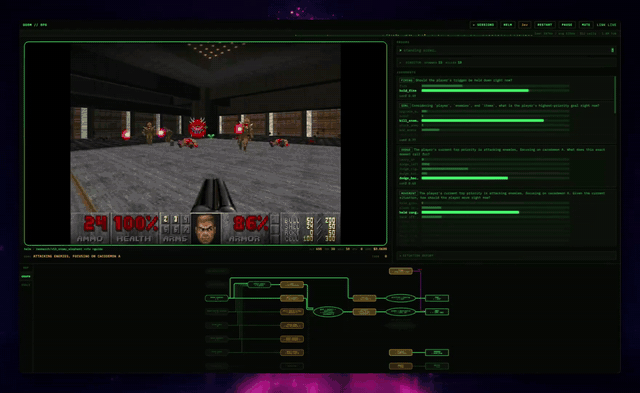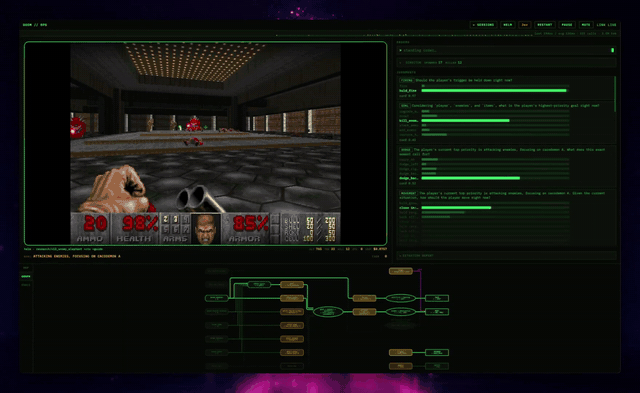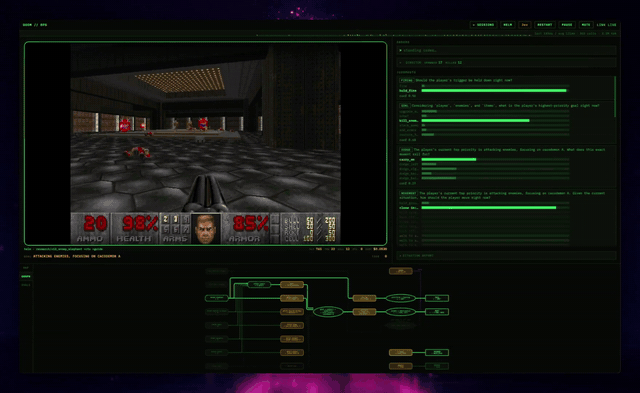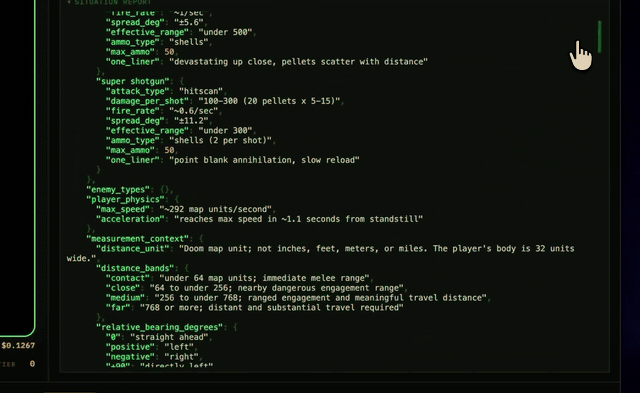
TypeSafe放出了兩個很有說服力的演示。一個是讓Jev實時打《毀滅戰士》,每秒做10次決策,一小時算力成本僅需7美元左右。
另一個是維基百科的超鏈尋路,從幾千個鏈接裏精準鎖定目標,單次候選上限高達255個。
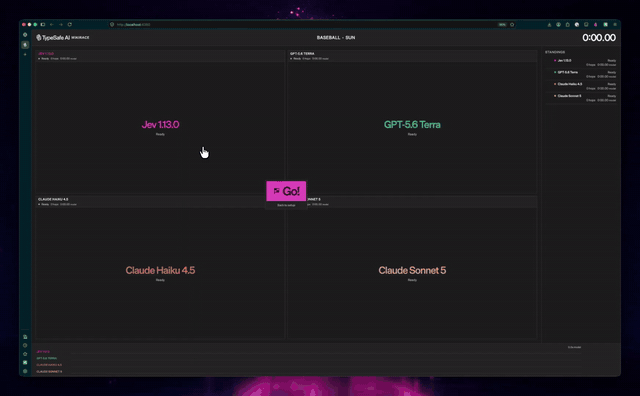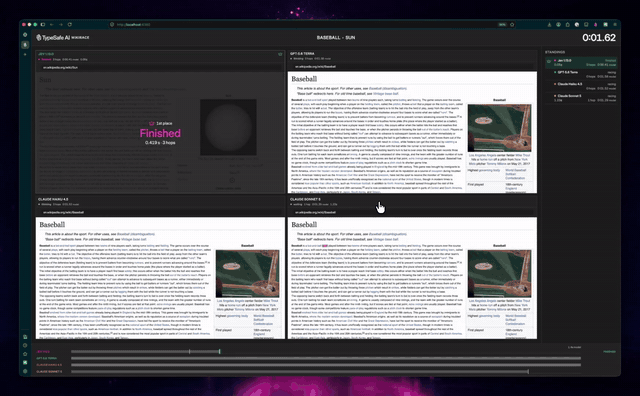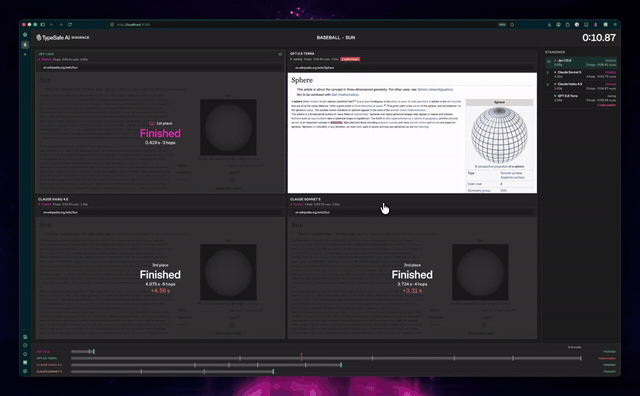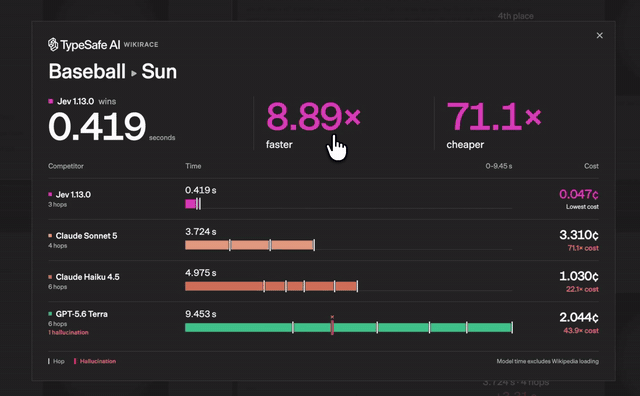
落到業務代碼,畫面是這樣的。
扔一段客訴給Jev問客戶是不是在暴怒,它可能回0.9,也可能回0.1。
如果你的軟件拿到的是0.9,那麼它就會直接拉響紅色警報;如果拿到0.1,可能就會扔進低優工單。整個過程,不需要任何人去讀那封郵件。
博客直言,Jev和現有大模型的關係不是替代,而是雙核搭檔。
大模型在前面負責吭哧吭哧幹活,Jev在旁邊花幾十毫秒,用概率給這活兒打個分,看合不合格。能過就放行,不能過直接打回重寫。
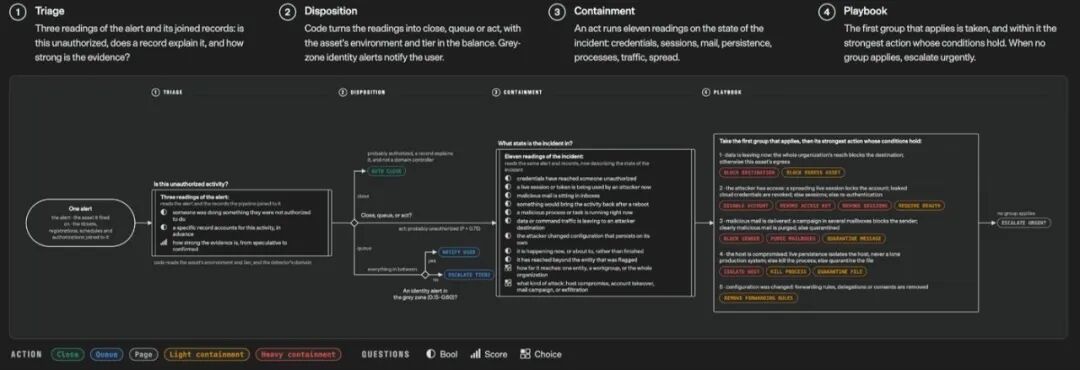
但這一切的代價是,Jev在面對需要一步步推導的數學推理時,頂多只有GPT-4的水平;並且,目前也不支持圖像輸入。
在一個絕大多數人還在圍繞文字生成找用例的時代,主動放棄文字輸出,無疑是一場巨大的冒險。
Jevons悖論:AI經濟的核裂變
Jev這個名字,取自經濟學中的傑文斯悖論:蒸汽機效率越高,燒掉的煤反而越多。
Almeida把模型命名為Jev,野心昭然若揭。
他在押注一個未來:當AI決策的成本趨近於零,速度快到令人髮指時,開發者對AI決策的需求不會減少,而是會像大爆炸一樣席捲所有代碼!
過去,大模型太貴太慢,我們只在最核心的地方使用AI。
但現在,如果每一次智能判斷只需要0.04美分,只需要幾十毫秒,那麼,你的代碼裏,將長出成千上萬個微小的、敏捷的神經網絡突觸。
據我所知,這是通往基於AI的經濟革命的最短路徑。
—— Diogo Almeida
這也是他給AGI為什麼還沒來的答案。
我們一直陷入這樣的誤區,以為AGI就是一個愛因斯坦式的超級大腦,越聰明越好,越會說越好。
而Almeida的解法是反過來的,先讓機器閉嘴,先讓它可靠,再讓它便宜到可以隨手用。
當百億個極速、廉價、可靠的「智能細胞」嵌進全球軟件的基礎設施,一張超越人類想象的自動化網絡,就已經形成了。
如果他賭對了,若干年後回頭看,從ChatGPT開始的這三年,會被寫成一段奇怪的彎路。
而拐彎的地方,就是今天。
參考資料:
https://x.com/testingcatalog/status/2099968075861008781