AI發展到了必須要降速的時刻嗎?
過去幾天,Anthropic、OpenAI先後釋放「放慢前沿AI能力推進節奏」的信號,被業內視作硅谷AI巨頭面對安全風險的一次主動降溫。二級市場率先做出反應,科技股、半導體股集體承壓,英偉達一度跌超3%,AMD、英特爾、美光盤中跌幅均在5%左右,費城半導體指數盤中也一度下挫近6%。
引發市場擔憂的,是支撐AI基礎設施高增長預期的關鍵假設迎來新變量:當一直踩着AI油門的人開始主動談「剎車」,「模型持續變強,圍繞算力、芯片和數據中心的資本開支不斷抬高」的增長邏輯不再那麼理所當然。
而這輪「剎車論」的源頭,指向一個長期帶有科幻色彩的命題:Recursive Self-Improvement(遞歸式自我改進,下稱RSI)。它所設想的,是一套AI開始參與改進、甚至構建自己下一代系統的自進化劇本。
2026年,RSI進一步跨出未來學和安全討論的範疇,成為AI學術議程、工程實踐和創業孖展敘事的熱詞。但跳脫情緒、迴歸技術,AI自進化究竟意味着什麼?今天AI的自我改進已經走到了哪一步,離真正的RSI還有多遠?
我們和長期耕耘在這條主線上的MIT PhD、前字節Seed團隊成員瞿驁聊了聊,以下是他的觀察。
RSI是一個技術交匯點,但現在還是個噱頭
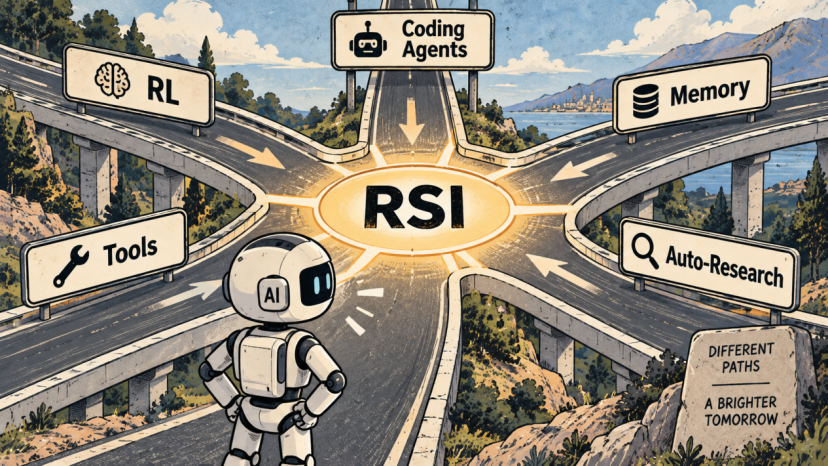
如果只看最近半年,會覺得RSI突然火了。但如果把時間拉長一點看,這並不是2026年橫空出世的新問題。它更像是過去幾年,幾條基礎路線一路演進,到今天向同一個方向匯合。
1.代碼不用人敲,RSI纔有了真抓手
我2019年開始做強化學習(RL)。那時我覺得,強化學習比單純做自然語言處理(NLP)更接近「智能」。因為它討論的是一個系統如何與環境交互、得到反饋,再改變自身行為。但當時能做的任務很有限,模型能力也遠不及今天。
ChatGPT的出現,刷新了人們對語言模型能力邊界的認知。語言模型有了更大的行動空間(action space),也第一次讓普通人感受到,一個模型可以通過自然語言持續接受指令、處理越來越複雜的任務。
再往後,reasoning(推理)能力一輪輪迭代。大家體感都很強烈的DeepSeek R1是一個很重要的節點,它讓人看到大規模強化學習能夠用到推理上,也讓行業重新看到強化學習在大模型時代的空間。
再往後,這種變化更加具象化了。Anthropic的Opus 4.5是一個很明顯的節點,到了這個階段已經可以連續工作很久,很多過去需要人手動拆解、反覆修改的任務,通過不斷輸入提示詞(prompt)、不斷調整,最後都能被做出來。我們甚至可以說,現在基本已經沒有什麼代碼是提示詞「敲」不出來的了。
這個變化對自我改進(self-improvement)很關鍵。因為智能體(agent)一旦有了足夠強的編程能力,再加上越來越成熟的上下文管理能力,它就可以在一個任務上持續跑很久,自行完成讀代碼、改代碼、執行、看結果、再繼續下一輪的循環。過去需要人來「插手」的很多環節,開始可以在同一個智能體循環(loop)自己跑完。
上下文管理也在這個過程中從一個「外接能力」,逐漸變成agent原生(native)的能力。它能記住自己做到哪裏,能管理越來越長的任務,再配合工具和代碼執行,長程任務這件事才變得可行。
所以在我看來,2026年最重要的變化,是AI開始有條件持續做一件事,這也是自我改進真正從概念開始變成工程問題的前提。
2.今天跑通的,只是RSI的「局部循環」
也正是在這個過程中,我開始重新看過去幾年那些貌似分散的研究方向。
一條線是AI驅動發現(AI for discovery),後來一路走到自動化研究(auto-research),即讓agent自己提出方案、跑實驗,再根據結果繼續探索。
另一條線則圍繞「如何讓agent越來越會做事」,改記憶、造工具、積累技能,或者繼續優化整個harness,也就是agent做事時依賴的那套工作框架。
我自己的研究路徑其實也橫跨了這兩條線。從強化學習、agent memory,一路做到多智能體自動化研究(multi-agent auto-research)。我們做CORAL的時候甚至會糾結,這到底算「自動化研究」,還是「智能體工作框架演進」(harness evolution)?
所以我現在看RSI,會覺得它雖然是個buzzword,但確實把很多事情串聯起來了。過去看起來像不同流派的東西,現在放進「AI如何參與構建下一代AI」這個框架裏,一下有了共同座標。
但這裏還需要區分清兩個概念。今天我們能看到的大多其實是持續自我改進(continual self-improvement):AI在和環境、用戶、任務不斷交互的過程中積累經驗,再用這些經驗去自我更新。它更新的不一定只是模型參數,也可以包括記憶、提示詞、工具、技能,甚至整個harness。
而嚴格意義上的RSI要更進一步。它的思想源頭之一,可以追溯到I. J. Good在1960年代提出的超智能機器(ultraintelligent machine):如果一台機器開始參與設計下一代機器,而且下一代又能繼續造出更強的下一代,能力提升就可能進入一個遞歸加速的過程。
換句話說,從一次次經驗裏把自己「煉強」,只是RSI的起點;再往前,AI還需要參與設計、訓練,甚至親手構建下一個自己。
它可以是改harness、改訓練流程、生成訓練數據;也可以繼續往更底層走,寫GPU內核(kernel),甚至參與設計下一代硬件。所以,我們把「機器」定義得越完整,RSI的門檻就越高。
按照我的理解,今天大量實踐更適合被稱為持續自我改進。嚴格意義上的RSI,還有很長的路要走。
而我們在自己做Reef時也更願意用改進(improve),而不是進化(evolve)。因為後者只說明「它發生了變化」。工程上我們更關心另一件事:你怎麼知道它真的變好了?
AI當然可以不斷變化,但變化本身沒有意義。它可能學到壞經驗,也可能把一次偶然的成功當成規律。人會「近朱者赤,近墨者黑」,模型也一樣。你不能讓它隨便「瞎evolve」。
AI把活兒幹完了,「長本事」才啱啱開始
1.幹得再久,不學習也只是「臨場發揮」
前面提到,我自己的研究一路從記憶做到多智能體自動化研究。這個過程中有一個問題越來越明顯:agent可以在上下文裏變得越來越能幹,但這種提升是有上限的。
我們後來做CORAL,讓多個agent自己做研究、共享信息、迭代方案。前期只靠上下文、記憶和harness的演進,效果可以推得很高;但任務一旦拉長,系統還是會慢慢卡住。
一個直觀的問題是,agent做了很多事,也積累了很多經驗,但模型本身並沒有因此「長本事」。
它可以記住這次哪裏踩過坑,多調用幾個工具,把工作流程調得更順。但任務結束以後,這些經驗大多還停留在上下文、記憶裏,沒有真正進入模型。這有點像一個人做項目時,靠着筆記越做越熟練,但項目結束以後,腦子裏並沒有留下多少東西。下一次碰到類似的問題,很多路還得重新走一遍。
所以後來我們開始做測試時訓練(test-time training)、測試時強化學習(test-time RL)、自蒸餾,想驗證的是:能不能把agent在真實任務裏產生的經驗,再學回模型裏。做下來以後,我們發現,這條路確實可以突破純推理(pure inference)的一部分上限。
接下來又有了一個問題:如果agent未來每天都在真實世界裏工作、每天都在產生新經驗,為什麼這些經驗只能用一次?
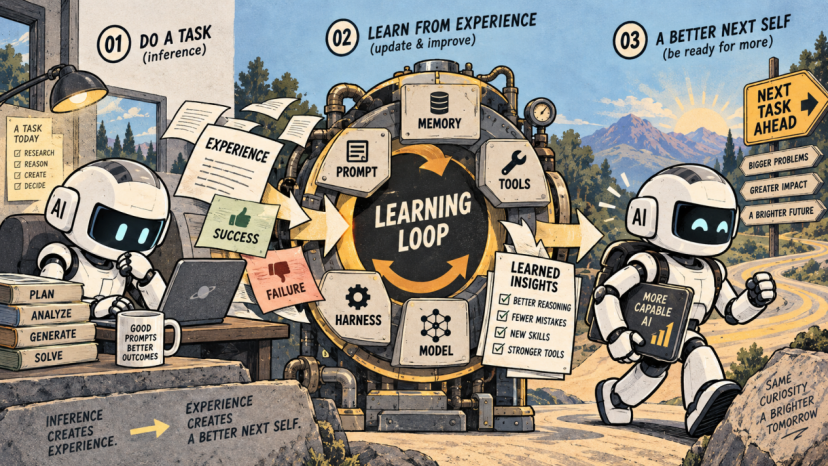
傳統的大模型開發,大致經歷訓練(Train)、評估(Evaluate)、部署(Deploy)、推理(Inference)這幾個階段。到了推理階段,模型開始替用戶幹活,但同步產生的大量經驗通常不會自動回到下一輪學習裏。
比如,它今天因為理解錯一個需求返工三次,明天遇到類似任務,未必會因為今天這三次返工就變得更聰明。
Reef想解決的,就是怎麼把這條路重新接起來,讓agent在真實世界裏做過什麼、錯過什麼、被用戶糾正過什麼,都有機會變成下一輪學習的材料。
所以對持續自我改進來說,推理不應該只是每一次任務的終點,也應該是新經驗產生的起點。AI每做完一件事,也可能是在為「下一個自己」積累經驗。
2.AI想越學越好,先得知道什麼叫「好」
不同任務裏自我改進的難度差別很大。
最簡單的一類,是結果好壞幾乎沒有爭議的任務,比如優化GPU kernel。agent每改一次代碼,都可以直接跑一遍驗證結果:更快了,還是更慢了?如果改法真的讓性能變好,那這條路徑就值得被獎勵;如果變差了,就說明這次嘗試沒有奏效。做得次數多了,模型就會慢慢學到,什麼樣的寫法和修改方式,更容易讓性能變好。
這類任務相對好做,因為驗證標準(verification)很清楚。快了就是快了,慢了就是慢了。
再複雜一點,是讓agent去「經營一家公司」。學術界有一個很有意思的benchmark(基準測試)叫CEO Bench,它會模擬市場環境,評估agent做經營決策的能力。我們跑這類任務時,如果模型一直不更新,有些agent會一路把公司幹破產。
但和kernel不一樣,經營這件事會不斷留下反饋:這次決策之後,客戶變多還是變少,現金餘額上升還是下降,公司最後是繼續活着,還是走向破產。agent得看一段時間之後的結果,才知道前面的決策到底是不是好決策。
所以到了這裏,反饋(feedback)已經不再是一個簡單的pass/fail(通過/失敗)。但只要這些變化能夠被識別、被歸因,它們就可以變成下一輪學習的信號。agent做得久了,也就有機會從自己的經營記錄裏不斷調整下一次決策。
再往上走,從部分維度來說,寫作風格這樣的任務更棘手。比如用戶反覆告訴一個agent:「我不喜歡太長的句子」「這個語氣太像AI」「我更喜歡直接一點的表達」。在同一輪任務裏,它當然可以照着改,但下一次遇到類似任務,它未必真的記住:這個用戶認為什麼叫「寫得好」。
我們在Reef裏做過一個方向,就是把這類反饋慢慢內化到模型裏,讓它在類似任務裏繼續保留這種偏好。
因為寫作這件事本來就沒有一個統一答案。有人喜歡短句,有人喜歡鋪陳;有人覺得直接最好,有人更在意語氣和節奏。模型再強,也不可能用同一套標準滿足所有人。
所以從kernel到CEO Bench,再到個性化寫作,更重要的變化其實是「什麼叫做好」。有的任務,「好」是一個數字指標;有的任務,要從長期結果裏看;還有一些任務,連「好」的定義本身都因人而異。而自我改進要繼續往前走,就必須能處理這些完全不同的反饋。
3.只「練模型」不夠,只「改打法」也不夠
經驗找到了,接下來還有一個今天行業裏討論很熱的問題:到底應該改model,還是改harness?
harness的確很重要,它可以理解成agent做事時的一整套方法、規則和權限。比如讓一個coding agent改代碼,好的harness不會讓它一上來就動手,而是先把整個代碼倉庫摸清楚,再決定從哪裏下手。
這些好的實踐經驗都可以慢慢沉澱到harness裏,把模型原有的能力更穩定地激發出來。它有點像給一個能力不錯的人配上一套更成熟的工作流程:同樣的人,方法更好,能做出來的事會穩定很多。
所以現在有一個比較流行的觀點,是harness進化的上限可能比模型進化更高。
但我對此有所保留。
因為harness再強,也只能告訴模型「應該怎麼做」,卻替不了模型做判斷(judgment)。它可以告訴模型「你應該先做規劃」,但這個任務到底該怎麼規劃,還是模型決定;它也可以告訴模型「把任務拆給幾個子智能體(sub-agent)」,但具體怎麼拆、每個agent做什麼,最後還是靠模型自己的能力。
另外,我認為現在直接比較harness evolve和model evolve誰的上限更高,其實有一點「不公平」。因為今天做model evolve,很多時候只能基於開源模型;但harness evolve往往直接建立在最強的閉源模型上。兩邊起跑線本來就不一樣。
從我們現在看到的結果來說,更值得探索的不是二選一,而是兩邊一起改進。
我們現在也在做模型與harness協同進化(model-harness co-evolution)。無論是兩邊同時訓練,還是先改harness、再訓練model、再繼續改harness,都能達到單獨只動一邊很難達到的效果。
所以,今天去爭「model evolve和harness evolve到底誰更重要」,可能還太早。而且harness以後可能也不只是一本越來越厚的「操作手冊」。好比一家公司不是給每個人發一份SOP就能持續運轉,它還需要績效、協作、激勵這些機制,才能讓不同的人穩定地一起工作。
未來harness也可能走向類似的形態:不只是規定agent怎麼完成一個任務,而是在設計一套讓一群agent可以長期evolve的機制。但只要問題涉及開放式判斷,最後還是要回到model本身。
4.經驗再多,也得知道怎麼「消化」
model和harness都能改以後,一個更難的問題出現了:得到一次經驗,到底應該改哪一邊?
我現在越來越覺得,這件事最後應該變成agent自己的一種元認知(metacognition)。它應該自己知道:這次經驗值不值得學?應該怎麼學?是先記在上下文裏,還是沉澱進模型權重(model weights)?
這個問題其實很像人自己學習。比如參加一場線上會議,有些內容會議助手把轉錄記下來就夠了;有些內容值得單獨記成筆記;還有一些東西特別重要,聊完以後還會反覆想幾遍,甚至順着它推導出新的結論。
人會天然地區分:哪些東西只是「記住」,哪些東西應該真的學進去。agent以後也需要這種判斷力。
因為一個agent不只有model weights。它還有記憶、工具、技能、harness。一次任務失敗,到底應該把模型練得更強,還是改記憶,還是調整工具,還是直接把做事流程換掉,答案未必一樣。
今天這些選擇,大多數還是人提前設計好的。再進一步,連「到底應該改哪裏、怎麼學」這件事本身,也應該逐漸變成agent的能力。
我會覺得,自我改進最後一定要走到這樣一步:不僅有經驗,還知道如何把經驗變成能力。如果這件事做不到,經驗再多,也可能只是堆在那裏。
對普通用戶來說,這種變化真正進入產品後,直接感知未必來自「模型又升級了」,而是一些更具體的細節。比如,同樣的任務過去需要更大的模型才能做好,持續學習後,小模型也能做好;或者之前糾正過的錯誤,下一次不再重複。
甚至於用戶不需要等到嚴格意義上的RSI。很多企業本來就有大量流程化任務,如果agent能把其中一類真正自動跑通、自己完成閉環,用戶其實已經會很明顯地感受到這種「自我進化」。
更多顯性的變化,還可能發生在harness上。比如用戶可以告訴agent:「這是緊急任務,3個回合內解決」;或者任務完成後,如果用戶一直沒有回來檢查,它可以主動換一種方式(如申請麥克風權限或者發送短信)來找你。
未來用戶感受到的「AI在進化」,未必是底層換了什麼模型。核心是要感受到,它越來越像一個合作久了的同事,知道事情該怎麼推進、怎麼收尾。
AI會學習,但離RSI還差好幾道坎
1.AI越學越多,也可能越走越窄
今天很多自我改進的局部loop已經可以跑起來,但真正開始讓模型持續學習以後,很快會遇到另一個問題:它學進去的東西,不一定都是對的。
我們做自蒸餾(self-distillation)的時候,就碰到過一個比較典型的問題:如果處理方式不對,它可能反而會損傷模型的推理能力。
比如我在解決一個問題時,可能先想到A,後來發現A不對;又想到B,還是不對;最後才找到C。如果最後只把「做C」這件事重新喂回模型,看起來它學到了正確答案,但中間A為什麼不對、B為什麼也不對,中間那些自我反思和自我否定其實全部丟掉了。最後答案學會了,找答案的過程反而丟了。
而很多真正好的判斷,恰恰來自這個過程。所以自我改進裏有一個很容易被忽略的問題:結果正確,不代表這段經驗就適合直接拿來學。
記憶也是一樣。我們早期做過經驗庫(experience library),把agent成功和失敗的經驗都存下來,做新任務時再把相關經驗調出來。剛開始效果會很好,但當記憶越來越多,又會出現新的問題:東西都在,但到了真的需要的時候,不一定能調回來。
還有一個更隱蔽的問題。agent走一條路走久了,很容易越走越順手,也越走越難回頭。agent在不斷採樣的時候,天然會更容易走那些概率比較高的路徑。如果它已經在一個方向上嘗試了很久,上下文會越來越強化這條路,它會越來越難跳出來。
這也是自我改進裏一個比較有意思的悖論:一個系統當然可能因為不斷學習而變強,但它也可能因為不斷學習,越來越被自己過去的經驗限制住。
所以「會學習」只是第一步,AI還得學會判斷:哪些經驗值得相信,哪些經驗應該忘掉,什麼時候甚至需要主動背離自己過去最熟悉的路徑。
2.現實世界最大的麻煩,是沒人隨時告訴AI「你做對了」
尤其對於開源研究來說,很缺的是真實的環境,以及真正適合持續學習的環境。
像kernel這樣的任務之所以舒服,是因為檢驗方法特別清楚。我改了一次,跑得更快還是更慢,馬上就知道。
但真實世界裏,大多數任務的反饋都沒有這麼「乾淨」。一個agent做了幾十步,最後任務還是失敗。問題到底出在哪?是最開始方向就選錯了,還是中途用了錯誤的工具,還是該記住的信息沒調出來,又或者某個子任務的判斷出了偏差?
更麻煩的是,最後失敗的那一步,往往並不是最早出錯的那一步。
你很難把「做得更好」壓縮成一個reward(獎勵信號),然後放心地讓模型一直朝那個方向強化。
所以今天其實已經不缺agent產生經驗。更稀缺的是:什麼樣的環境,可以持續給它高質量、可驗證,而且不會把它帶偏的學習信號。這件事決定了自我改進最終能不能從幾個benchmark上的局部成功,走進真實世界。
3.基礎模型再強,也不可能提前經歷整個世界
這裏還有一個我覺得經常會被問到的問題:如果下一代基礎模型又強很多,這些continual learning的問題是不是自然就消失了?
我自己的判斷是,不會。因為模型再強,也有一個很難繞開的限制:它不可能在訓練階段,就提前經歷未來部署後會遇到的所有事情。
我把這個問題稱為experience exposure(經驗暴露)。可以讓一個模型見過最難的數學題、讀過很多代碼、學過大量知識,但真正部署到一個具體環境裏,它總會遇到訓練階段沒見過的規則、用戶和情境。
這其實和人很像。你就算是一個很聰明的教授,突然讓你去一所小學教課,也還是得先知道這所學校怎麼運轉、班裏每個學生是什麼情況。不是因為能力不夠,而是因為這些事情以前根本沒經歷過。
所以我不太把持續自我改進(continual self-improvement)理解成一個「弱模型時代的補丁」。恰恰相反,模型越強、進入的真實場景越多,它越需要從自己的經驗裏繼續學習。
上下文學習以後能覆蓋的事情可能會越來越多,但我自己還是傾向於認為,只靠「記住當下」還不夠,模型權重最後也需要能夠持續更新。
4.AI能走多遠,還看人願意放多少權
但即便上面這些問題都解決了,持續自我改進也還不等於RSI。
嚴格意義上的RSI,要求AI進一步參與到「下一代AI是怎麼被造出來的」這件事當中。
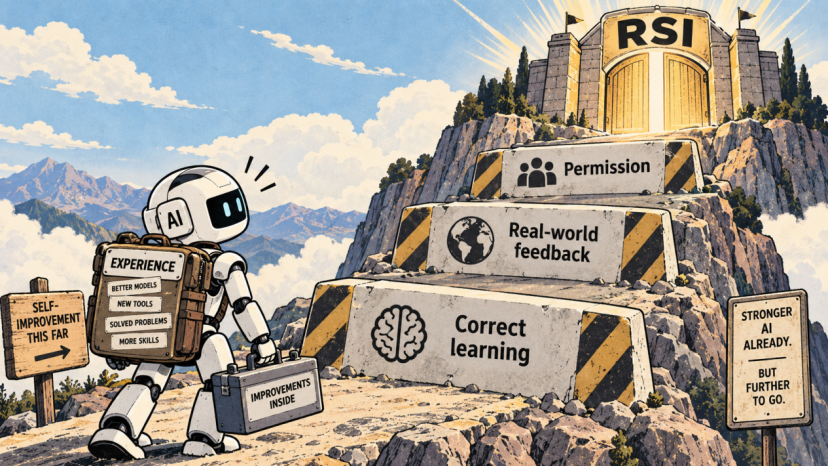
所以在我看來,走向RSI的過程中,有兩條線一起往前:一條是能力(capability),另一條是權限(permission)。能力決定它會不會做,權限決定它到底能不能做。
比如最早的coding copilot,只能幫你補一小段代碼。它能做的行動空間就這麼大,再聰明,也沒有地方讓它表現出更復雜的系統設計能力。
但當agent可以訪問整台電腦、改整個代碼庫、調用越來越多的工具之後,它突然就有了更大的提升空間。
把這個邏輯繼續往下推,真正嚴格意義上的RSI涉及的範圍會非常大。它可能不僅是改harness,也不僅是調模型權重。它還可能要參與訓練流程、生成訓練數據、寫kernel,甚至觸碰更底層的基礎設施和硬件設計,那它離「參與造下一代AI」也就更近了一步。
所以我覺得,真正值得關注的那個拐點,未必是某一天突然出現一個benchmark,然後大家宣佈「RSI實現了」。
更關鍵的時刻是:當agent在「造agent」這件事上的判斷力和能力,第一次達到甚至超過優秀的人類研究者時,那個時候可能纔是更加值得關注的拐點。
但問題也恰恰在這裏。它越有可能更早進入更深的自我改進;可權限越大,安全問題也會越具體。
所以今天RSI到底有多遠,已經不只是一個技術問題。另一條線其實一直掌握在人手裏:我們願意讓AI把手伸到哪裏。
回看六十多年前,I. J. Good設想過的那個「機器製造更強機器」所帶來的智能爆炸(intelligence explosion)。今天RSI距離那個臨界點還有多遠,答案可能已經不只寫在技術進展裏,也取決於我們願意讓AI把手伸到哪裏。
AI會繼續向前,但最終走到哪裏?邊界不會只由機器自己決定