近日,智象未來旗下內容創作智能體 vivago R1 全球上線,國內版本「夠搭」全新升級發布。
這不僅是版本迭代,更是一次行業信號的釋放。可以說,vivago R1 的上線標誌着 AI 視頻創作邁入「單反級交付時代」。過去需要一整個專業團隊才能完成的高品質大片,如今或許每一位普通創作者就有機會獨立完成。
如果說 Sora 用 15 秒視頻驚豔了世界,為 AI 視頻生成打開了一扇門,那麼時至今日,行業仍徘徊在 15 至 30 秒的片段式生成階段。而 R1 的突破正在於此:它能夠一次性穩定輸出 5 分鐘高質量視頻,並支持無限次多輪延長。從此,AI 視頻不再只是「驚豔一刻」,而開始擁有完整的敘事長度與表達縱深。
事實上,長視頻生成的瓶頸從來不是單純的時長數字,而是敘事的可持續性,即如何讓故事在多鏡頭、多角色、多場景之間持續成立。R1 的解法是一套 Agent 調度系統:主 Agent 拆解創意,子 Agent 協同完成腳本、分鏡、角色、場景與音效,確保角色形象、場景風格與敘事節奏在多段落中始終統一。而支撐這套系統運轉的,是智象自研的 HD-AgentOS 全流程調度與治理能力。在其加持下,R1 內容有效可用成功率提升至 85%,視頻創作從「碰運氣」走向「可預期」。
時至今日,AI 視頻競賽早已走出比拼幾秒炫酷片段的早期階段。算力與模型能力不斷迭代,拉長視頻時長只是表層結果,能否守住敘事邏輯、守住角色與場景的連貫,纔是通往工業化內容生產的關鍵。R1 與「夠搭」的落地,不只是把長時長工具交到創作者手中,也在重新定義 AI 視頻的評判標尺,相比炫技式的視覺奇觀,可信賴、可延續的完整敘事,纔是 AI 影像真正走向實用化、落地化的必經之路。
就在 R1 上線一周之後的 9 月 15 日,智象再度正式發布原生全模態音視頻生成模型 HiDream-O1-Video-1.0。
AI 長視頻真正分水嶺:故事合理、敘事真實
在智象未來的產品理念中,優秀的 AI 創作工具應當順應人的表達本能。落到視頻創作場景,創作的起點不該是節點、畫布、參數這類技術要素,而是創作者本身想要傳遞、表達的內容。
基於這一思路,R1 採用 Chat-First(對話優先)的產品路線。對話是人類最自然的表達形式,同時也是對 AI 十分友好的交互入口。用戶僅需輸入自然語言描述創作訴求,R1 就能夠自動產出視頻,還可以依託對話交互,持續對作品進行調整、迭代。
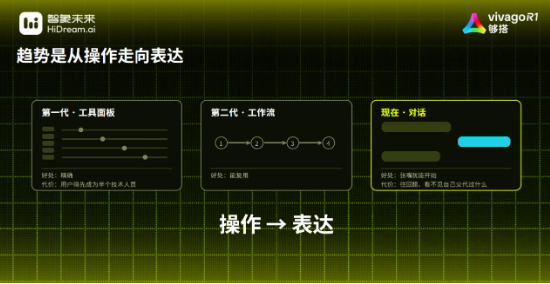
這種體驗背後,vivago 遵循「做後」與「做厚」兩條原則。「做後」,是把專業創作者的判斷、審美和經驗編碼進 Agent 編排能力,形成強大的中後台;「做厚」,是構建 SkillHub,將抽象 AI 能力轉譯為產品廣告、角色視頻、故事短片、品牌內容等真實創作場景,讓用戶更容易理解能做什麼、如何開始。
長視頻生成領域,繞不開一大核心痛點:內容一致性。如何讓同一個人物、同一種聲線,在數十組鏡頭、多輪生成過程中維持形象、風格統一?智象未來選擇以「基礎模型 + 智能體系統」雙輪驅動作為解決方案。
一方面,自研原生全模態世界模型為 R1 提供多模態理解與生成底座。它能將文本、圖片、視頻、參考資產、文檔說明與歷史創作結果納入同一任務語境,讓 Agent 理解「任務全貌」,而非執行單點指令。另一方面,智能體系統將模型能力組織為可持續推進的創作流程,在腳本、分鏡、角色、場景、鏡頭與音效之間統籌調度,確保複雜敘事中角色形象、聲音特徵與風格前後統一。
在此基礎上,R1 推出資產庫功能,沉澱用戶生成、篩選並認可的內容,供後續創作複用。一次創作不再是一次性輸出,而成為下一次創作的素材基礎。
談及「無限時長」要攻克的最大難題,vivago 產品負責人弓子健給出了一個清晰的判斷:「無限時長」的本質,不是「能生成一小時就很牛」,而是在更長的敘事跨度裏,始終保持敘事合理、人物一致、劇情連貫。
他將這背後的支撐體系概括為「長長穩」,三件事缺一不可:第一是「長」,即無限時長本身;第二是「長思考」,負責在開頭建立完整的世界觀和故事框架;第三是「穩」,即穩定生成,確保敘事不崩。
而保證「穩」的核心,是系統能夠「記得住」。「這本質上是 context engineering,上下文裏該記住的都要沉澱下來,不能前一段記得角色穿紅衣服,後面就丟失設定,開始自由發揮。」弓子健解釋。在他看來,最終的評估標準只有一個,就是邏輯合理。「畫面好看已經是基本功,任何產品都可以畫面好看。故事合理、敘事真實,纔是不同產品拉開差距的真正分水嶺。」
至於 vivago 怎麼保持角色、場景和事件狀態的長期一致?弓子健表示,「vivago R1 的 Agent 是從基礎模型裏長出來的,源於團隊做過圖像模型、視頻模型、交互式世界模型,這些積累讓我們知道 AI 如何構建世界、Agent 的方向在哪。做模型的人清楚模型的上限在哪裏,也知道怎麼通過 Agent 的設計把上限拉高、把短板補齊。這就像讀過很多書的人,寫作時不會照搬任何一本書的寫法,但功力都在。」
這份「功力」在本周有了新的註腳。9 月 15 日發布的HD-V1,被定位為「首款物理規律導向視頻模型」——長視頻的地基,是單鏡頭的質量上限。該模型原生支持 5-20 秒任意時長單鏡頭生成,輸出 1080p 高清畫面,並會根據輸入內容自主確定合適時長:讓「講多久」服務於「講什麼」,而非反過來遷就模型的固定模板。R1 一次輸出 5 分鐘的成片,正是由這類高質量單鏡頭經 Agent 規劃調度組合而成——先有「一段一段都成立」,纔有「一整部都成立」
同時,「HiDream-O1-video從架構之初便面向文本、視頻與音頻的統一表徵。」智象未來 CTO 姚霆表示,「它不只是‘把畫面做出來’,更是把用戶意圖翻譯成可執行的專業分鏡,並同步生成可信的聲音。這是原生全模態技術從‘看得清、動得順’,邁向‘聽得懂、說得準、演得連貫’的關鍵一步。」
直面本土創作者真實訴求
近期,AI 版《西遊記》在社交媒體刷屏出圈,引發廣泛討論。有創作者藉助 R1 對這部國民經典進行二次演繹,生成了近五分鐘的西遊主題視頻作品。無論是人物角色的造型塑造、故事場景的氛圍感渲染,還是獨樹一幟的東方奇幻氣韻,都直觀展現出 R1 對經典文本強大的視覺轉譯與落地能力。
優質的落地能力,讓 vivago 在全球範圍內快速成長。據悉,2024 年 5 月,vivago.ai 上線,成為全球最早一批公開可用的 AI 視頻生成產品;今年 5 月,vivago.ai 登頂 Product Hunt 日榜第一;今天,vivago.ai 全球用戶突破 7000 萬。兩年時間,智象從「第一個可用」走到第一個「單反級交付」。
伴隨 HiDream-O1-Video-1.0視頻模型的發布,智象同步完成 C+ 輪孖展,投資方包括新微資本、交子資本、工銀資本——國資及產業資本正加速向原生全模態世界模型賽道聚攏。
談及商業模式,弓子健談到,「我們商業模式跟着用戶的消費能力和成熟度走,兩年前用戶把 AI 訂閱當玩具,今天越來越多創作者把它當生產資料,預期它能幫自己把錢賺回來,消費心態發生了根本變化。」並坦言,「我們不會做性價比生意,一條兩百塊成本能賣一萬塊的片子是創意生意,一條一千塊只能賣兩百塊的是體力生意,我們做前者,因為創意無法被完全量化,一旦可量化,就進入了價格戰。我們希望讓更多普通人具備專業級的表達能力,而不是讓所有人去搶專業創作者的飯碗,而是讓這種能力被用在社媒表達上。」
過去,vivago 的業務重心長期放在海外市場,收穫了全球大量創作者的驗證。此番國內版本「夠搭」全新升級正式發布,也意味着這套經過海外市場打磨的長視頻創作智能體能力,正式落地國內,直面本土創作者的真實需求。
弓子健表示,「vivago 從海外出發麪向全球,現在國內已擁有成熟的創作者生態,國內專業創作者對工具的付費決策邏輯已和海外用戶相近,大量創作者也會把內容輸出到海外平台。伴隨國內創作者內容質量、商業化能力持續提升,夠搭選擇和海外版同步發布,以此服務包括中國創作者在內的全球用戶。」
至於國內大廠也在做同類產品,智象未來的優勢在於哪裏?弓子健表示,「大廠的優勢非常明顯,在成熟市場裏擠壓成本。但 AI 視頻現在還沒有穩定的場景可以擠壓,大家都在開闢新場景,這恰恰適合創業公司。」
他坦言,自己常和團隊講一句話:「新瓶一定要裝新酒。」在他看來,市面上很多產品,要麼是舊需求套上 AI,要麼是新需求套傳統產品形態。「我們要做的是新需求加新產品形態,如果只求四平八穩,我們肯定幹不過大廠,要做出讓用戶覺得爽的產品,纔有機會。」