兩周時間,10 萬顆國產 AI 加速器,一個開始優化自己的模型。
就在啱啱,智譜 GLM 首席科學家唐傑在 X 平台分享了一項關於 GLM-5.3-Flash 推理系統優化的研究。
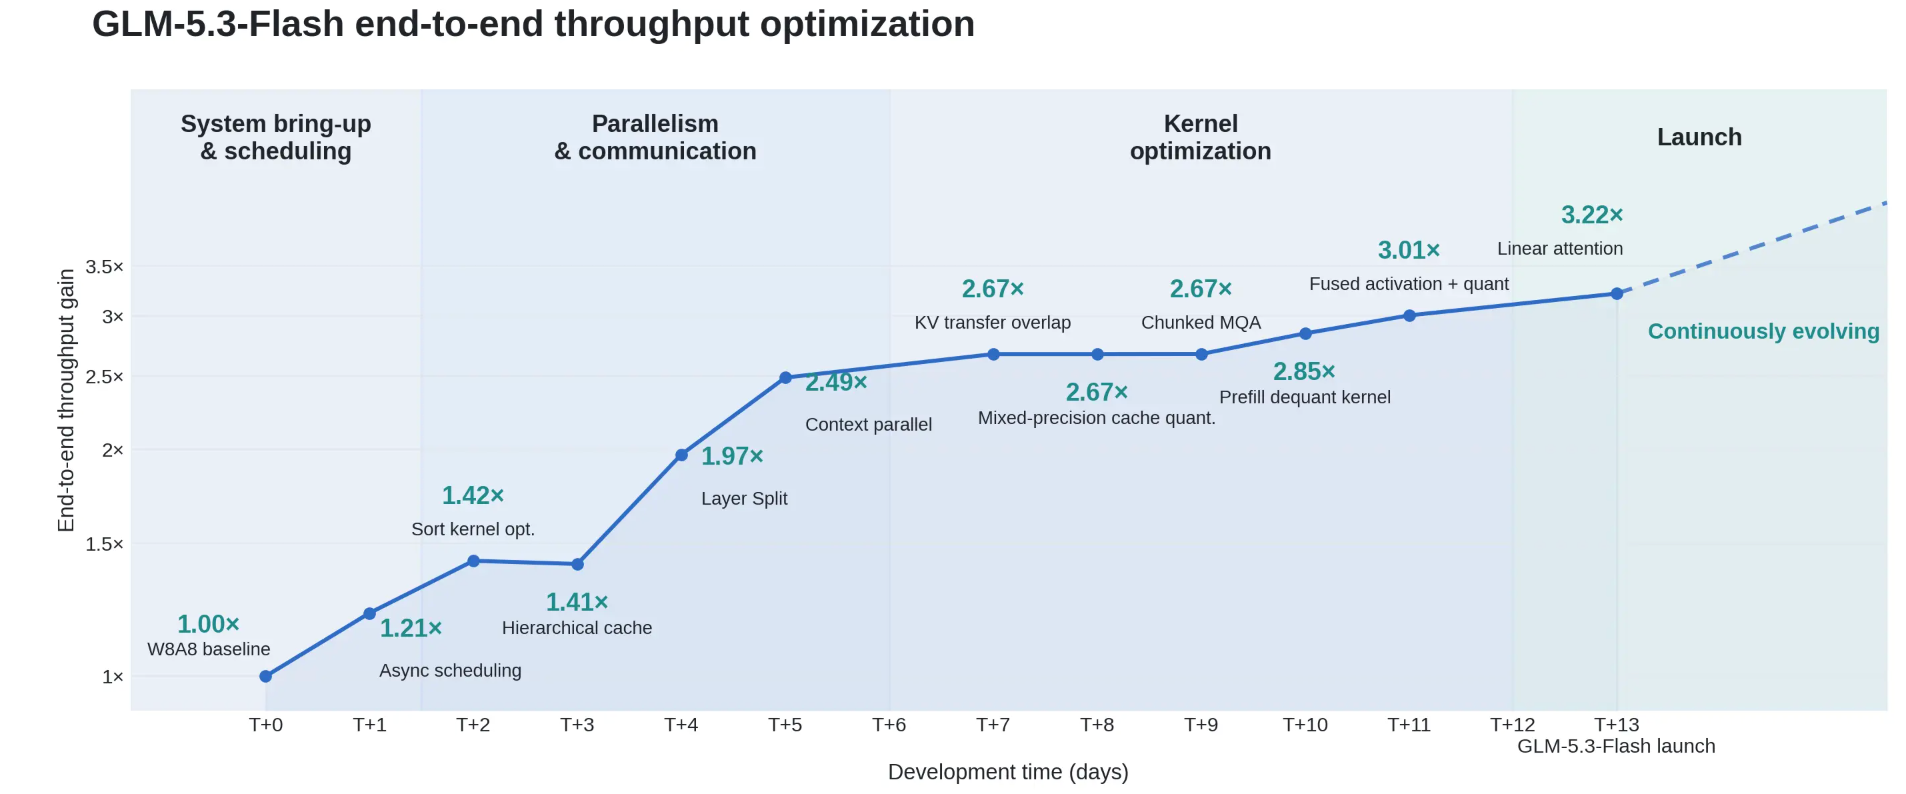
他透露,從 GLM-5.3-Flash 首次運行在國產 AI 加速器上,到完成全部生產流量承載,僅用了兩周時間。在這個過程中,系統端到端吞吐能力提升了 3.2 倍。
最讓唐傑印象深刻的是,完成大量優化工作的並非只有基礎設施工程師,還有一個由 GLM-5.3 驅動的 Infra Agent。
「一個幫助優化服務自身的模型。」唐傑這樣描述這一變化。
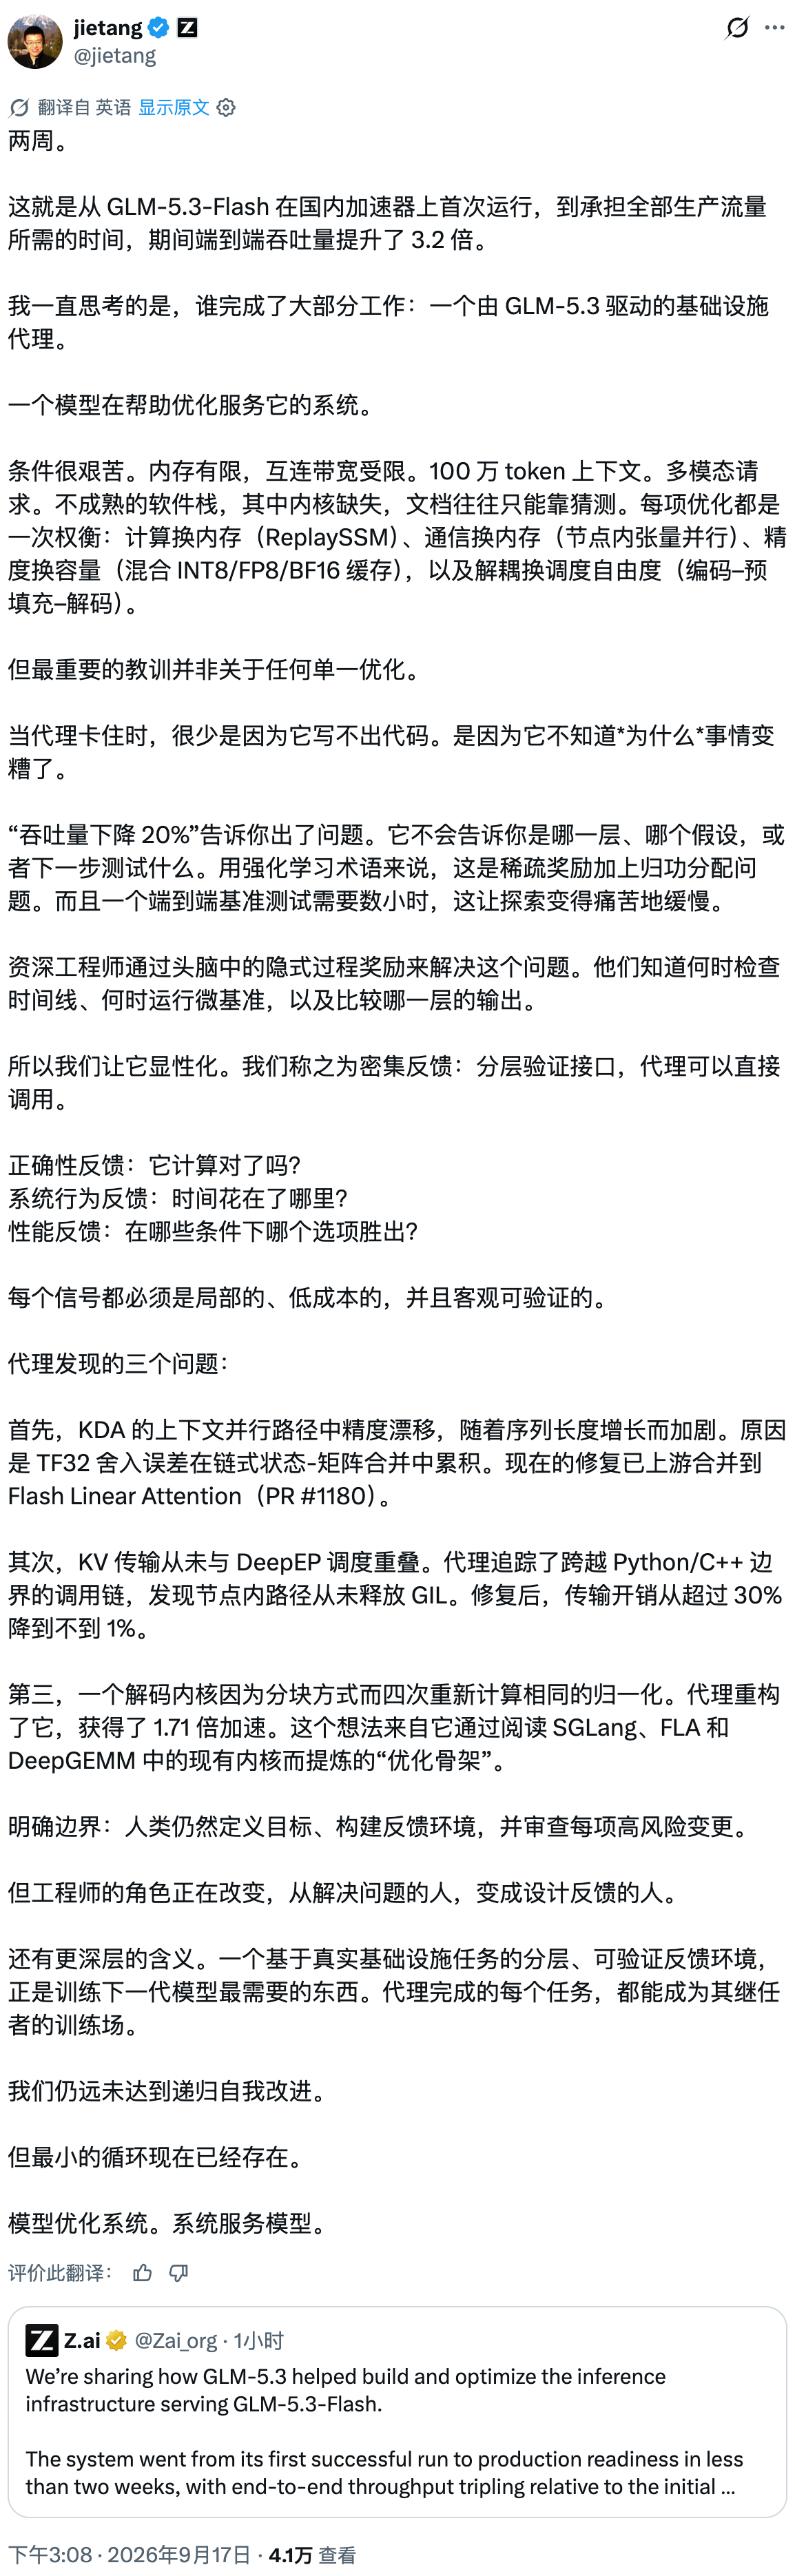
在他看來,這意味着 AI 開始參與優化承載自身運行的系統。雖然距離真正意義上的遞歸自我改進(Recursive Self-Improvement,RSI)仍然很遠,但一種早期形態已經出現。
智譜團隊也提到,過去一年裏,他們觀察到 GLM 的角色正在發生變化。
最初,團隊探索 GLM 在代碼理解和網絡安全領域的能力,希望讓模型幫助分析複雜代碼中的漏洞。但隨着模型能力提升,GLM 開始參與構建 AI 系統本身。
團隊表示,他們曾觀察到模型完成一些過去需要資深基礎設施工程師團隊花費數周才能完成的任務,而這些工作又會直接影響下一代模型訓練和部署方式。
兩周完成國產算力集群部署
將一個大模型從新硬件上的首次運行,推進到能夠穩定承載生產請求的推理服務,需要大量系統工程工作。
GLM-5.3-Flash 此次部署運行在超過 10 萬顆國產 AI 加速器組成的集群上。智譜團隊表示,這是一次此前缺少成熟經驗參考的大規模部署。
團隊需要解決多個問題,包括國產芯片顯存容量和互聯帶寬限制、新模型架構適配、100 萬 token 長上下文支持,以及多模態請求處理等。與此同時,國產 AI 加速器的軟件生態仍處於發展階段,部分 Kernel 支持不足,很多資料也需要工程團隊自行探索。
唐傑表示,在這些限制條件下,GLM-5.3 驅動的 Infra Agent 參與了推理系統優化過程,幫助分析性能瓶頸、提出優化方案,並完成部分代碼修改。
整個優化過程並不是簡單增加計算資源,而是在算力、內存、通信和調度之間尋找新的平衡。
智譜團隊採用了一系列優化方案。例如,通過 ReplaySSM 用計算換取內存空間,通過節點內張量並行降低顯存壓力,通過 INT8、FP8、BF16 混合精度緩存提高容量利用率,同時引入 Encode-Prefill-Decode(EPD)分離式架構,讓不同推理階段能夠更加靈活地調度。
最終,GLM-5.3-Flash 的端到端服務性能相比初始版本提升約 3 倍,硬件利用率和單 token 成本達到接近主流 NVIDIA GPU 平台的水平。
部署完成後,GLM-5.3-Flash 還進入真實使用環境測試。智譜團隊介紹,該模型曾以匿名模型名 Ox-Alpha 運行在 OpenCode 和 OpenRouter 平台,一周內成為兩個平台使用量最高的模型之一,六天處理超過 62 萬億 token。
不過,這次實驗真正的變化,並不只是讓 AI 寫代碼,而是讓 AI 能夠理解複雜系統為什麼出現性能變化。
唐傑提到,Infra Agent 遇到困難時,很少是因為無法編寫代碼,而是無法判斷「為什麼結果變差」。
例如,當系統反饋「吞吐下降 20%」時,它只能說明某個地方出現異常,卻無法直接告訴 Agent 哪一層出了問題,當前假設是否錯誤,以及下一步應該驗證什麼。
對於資深工程師來說,這類判斷依賴長期經驗。工程師知道什麼時候查看執行時間線,什麼時候運行微基準測試,以及應該比較哪個模塊的輸出。
智譜團隊希望把這種工程經驗轉化為 AI 可以調用的反饋機制,並將其稱為「dense feedback」。
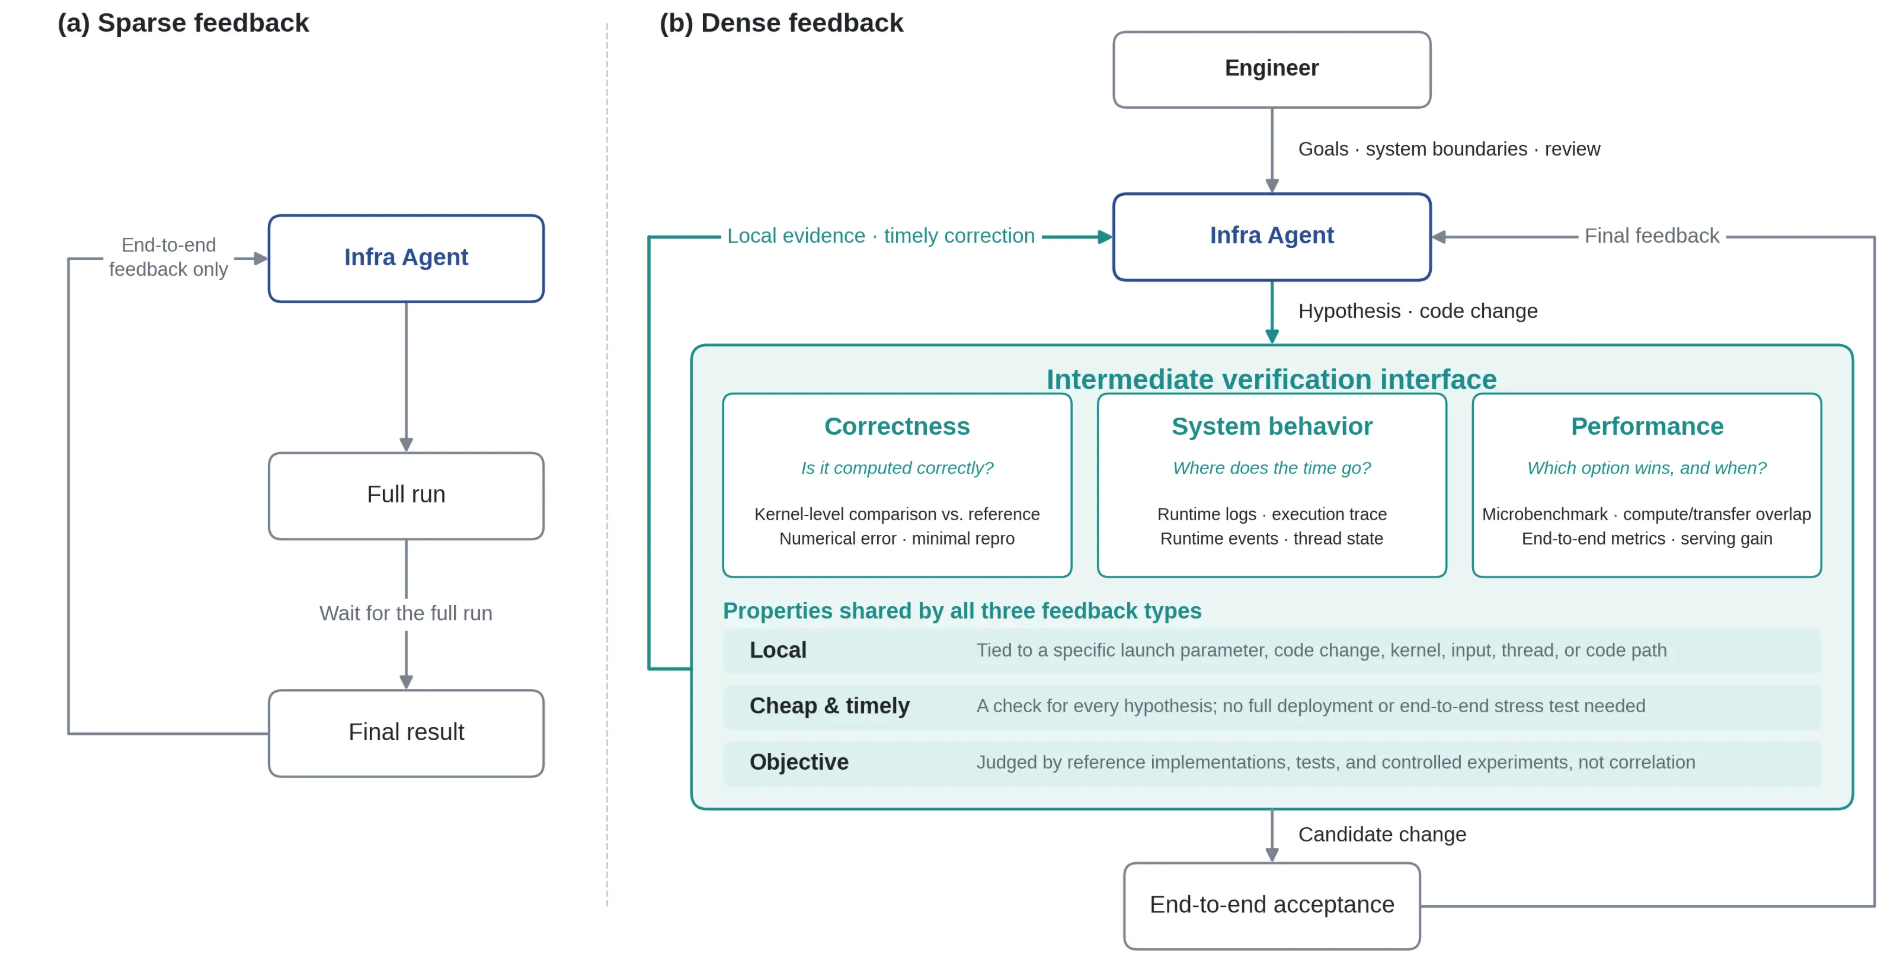
這套機制的核心,是讓 Agent 獲得更加接近工程判斷過程的信息。
當模型需要確認計算是否正確時,它可以獲得對應的正確性反饋;當模型需要分析性能下降原因時,它可以查看系統運行過程中的時間消耗;當模型嘗試新的優化方案時,它可以通過實驗判斷該方案是否適用於當前場景。
智譜團隊認為,真正有效的反饋需要滿足幾個條件,它必須足夠接近具體問題,能夠快速獲得,同時能夠通過客觀實驗驗證。否則,大量日誌和指標反而可能讓 Agent 難以判斷下一步行動方向。
「模型優化系統,系統服務模型」
在 dense feedback 的幫助下,Infra Agent 開始參與定位推理系統中的隱藏問題。
在 KDA 的上下文並行路徑中,Agent 發現了一個影響長上下文計算精度的問題。
由於不同上下文分片之間需要不斷合併狀態矩陣,TF32 計算產生的舍入誤差會隨着序列長度增加不斷累積,最終導致計算結果偏差。
Agent 通過比較不同執行路徑的結果,將問題定位到狀態傳播和合併過程中的精度處理。相關修復已經合併到 Flash Linear Attention 項目 PR #1180。
另一個問題出現在 KV Transfer 與 DeepEP 調度之間。
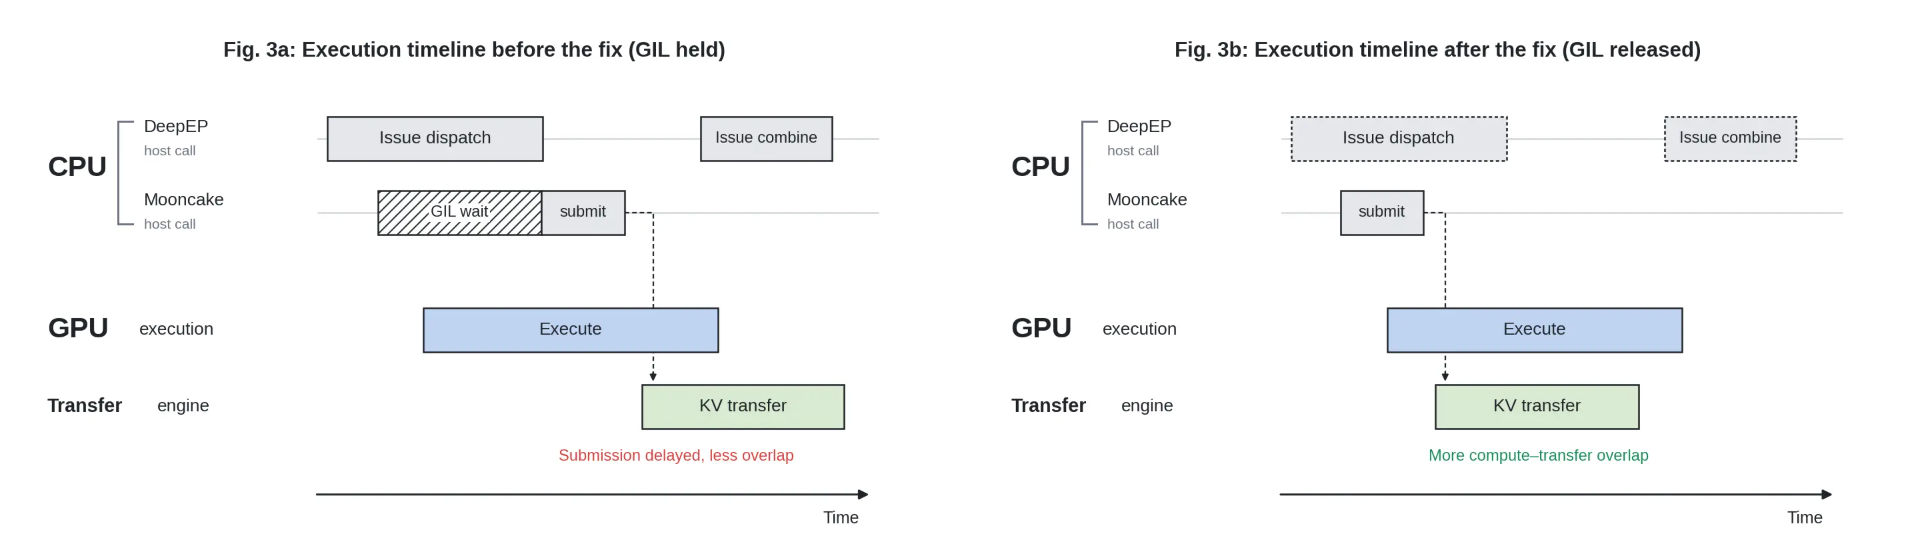
測試過程中,Agent 發現 KV Transfer 沒有與 DeepEP Dispatch 形成有效重疊,導致部分場景下傳輸開銷超過 30%。
隨後,Agent 沿着 Python 與 C++ 調用鏈繼續分析,發現節點內路徑沒有及時釋放 Python GIL,使傳輸任務無法及時推進。
完成修改後,KV Transfer 帶來的額外開銷從超過 30% 降低到 1% 以下。
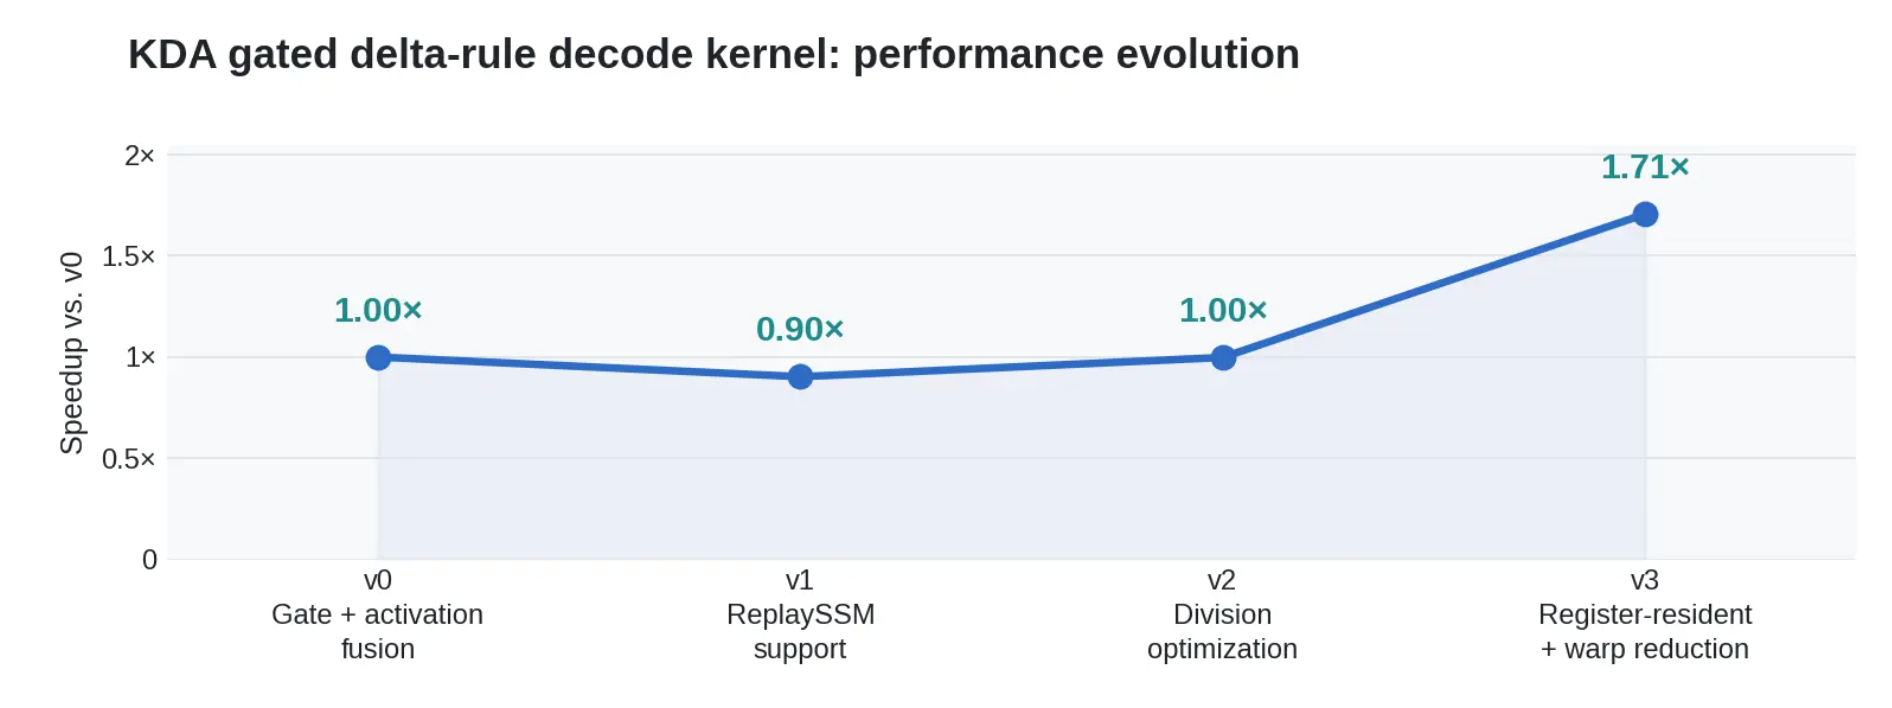
此外,Agent 還優化了一個 Decode Kernel。
它發現,由於 Kernel 切分方式的問題,同一組歸一化計算被重複執行四次。通過重新組織計算結構,減少重複計算,該 Kernel 最終獲得 1.71 倍性能提升。
這一優化思路來自 Agent 對 SGLang、Flash Linear Attention 和 DeepGEMM 等項目現有 Kernel 的學習。它將這些代碼中的優化經驗提煉成「optimization skeleton」,再結合當前系統反饋判斷是否適用。
過去,類似優化經驗主要依賴工程師個人積累。
而在這一過程中,Agent 開始能夠從已有代碼中學習優化方法,再通過實驗驗證這些方法是否適合新的硬件和模型環境。
唐傑表示,人類工程師仍然負責設定目標、搭建反饋環境,以及審核高風險修改。
但工程師的角色正在變化,從直接解決每一個問題的人,逐漸轉向設計反饋系統的人。
智譜團隊認為,建立在真實基礎設施任務上的可驗證反饋環境,可能也是訓練下一代模型的重要基礎。每一次 Agent 完成工程任務,都可能成為下一代模型學習的數據。
目前,GLM-5.3-Flash 的案例距離真正意義上的遞歸自我改進仍然存在距離。
但唐傑認為,一個最小規模的循環已經出現。
模型優化系統,而系統服務模型。